觀點 · 資訊分享
Ollama 0.21.0:Mac 可用 MLX 跑 Gemma 4,一行指令啟動 Hermes 與 GitHub Copilot CLI
本地模型工具 Ollama 發布 0.21.0:Apple 晶片的 Mac 能用 MLX 跑 Gemma 4,ollama launch 新增 Hermes Agent 與 GitHub Copilot CLI 兩個整合,並修掉幾個建置與設定寫入的問題。
- 發布
- 2026-04-17
- 篇幅
- 約 3 分鐘 · 1,536 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
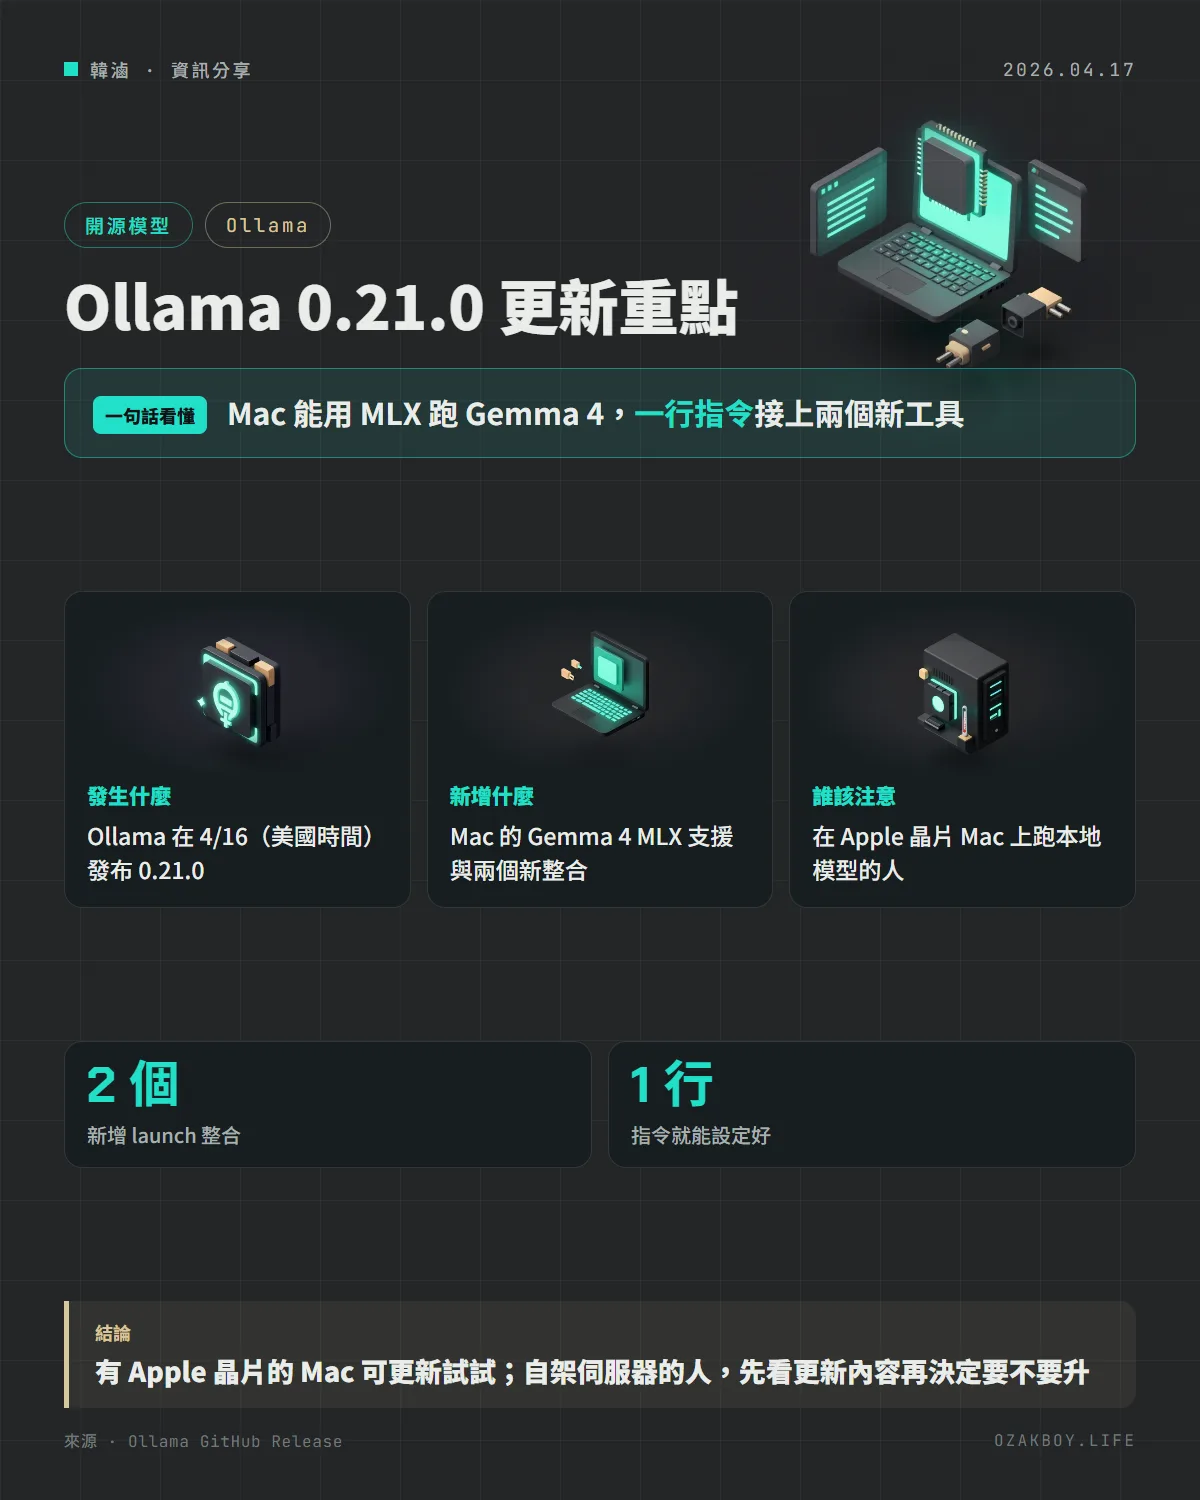
一句話看懂:Ollama 0.21.0 讓 Apple 晶片的 Mac 可以用 MLX 跑 Gemma 4,並新增兩個一行指令就能接上的程式碼代理工具:Hermes 與 GitHub Copilot CLI。
先用白話講:Ollama 與 MLX 是什麼?
想像 Ollama 是一個「AI 模型的行動電源插座」:你想在自己的電腦上跑 AI,不必自己搞懂各種模型怎麼安裝、怎麼設定,它幫你處理好,一行指令就能開始用。
MLX 則是 Apple 為自家晶片做的機器學習框架,專門讓 Mac 的晶片把 AI 運算跑得更有效率。這次 Ollama 讓 Gemma 4 這個模型,可以走 MLX 這條路。
發生什麼事
Ollama 在 4 月 16 日(美國時間)發布 v0.21.0,主要內容有:
- Gemma 4 on MLX:新增在 Apple 晶片上用 MLX 執行 Gemma 4 的支援,包含只處理文字的 MLX 執行環境。
- MLX 後端強化:加入混合精度量化、更好的能力偵測,以及一批新的運算包裝(Conv2d、Pad、啟動函式、三角函數、masked SDPA、RoPE-with-freqs 等)。
- 新增兩個 launch 整合:Hermes Agent 與 GitHub Copilot CLI,可以和其他支援的程式碼代理一起,用一行指令設定好。
新的整合是什麼?
ollama launch 是 Ollama 用來「把本地模型接到某個工具上」的指令。這次多了:
- Hermes Agent:用
ollama launch hermes啟動。官方形容它會跟著你學習,自動建立技能,適合研究與工程任務。 - GitHub Copilot CLI:同樣可以用一行指令設定。
其他修正
- OpenCode 的設定改成直接寫在內嵌設定裡,不再另外寫一個檔案,和其他整合的處理方式一致。
ollama launch在沒有任何改變時,不再重寫設定檔。以前在已設定好的多模型整合上按 → 或帶--model,會跳出確認並重寫編輯器設定與config.json。- 修正
ollama launch openclaw --yes沒有正確略過頻道設定步驟的問題。 - 還原 Gemma 4 的 nothink 渲染器;修正 Gemma 4 讓 Metal 建置失敗的編譯錯誤;修正 macOS 交叉編譯與 cgo 警告的問題。
給開發者的技術細節
- 版本:v0.21.0,相對於 v0.20.7。
- 這次的 MLX 支援寫的是「只處理文字」的 MLX 執行環境,也就是 Gemma 4 的圖片等功能沒有在這則說明裡提到。
- 發行頁沒有寫效能數字,實際快多少,要自己在機器上量測。
我的看法
我家的 AI 主要是在 NAS 與一台有顯示卡的主機上跑,不是 Mac,所以這次的 MLX 支援對我是「知道就好」的更新。但 ollama launch 這個方向我滿喜歡:把本地模型接上各種寫程式工具,以前每個工具都要自己改設定,現在一行指令,少踩一些設定檔的坑。
對接案的人來說,如果客戶很在意資料不能外流,本地模型加上程式碼代理,是一個可以拿來討論的組合。不過我會先小規模試用,確認品質夠用再談導入,不要因為功能多就直接升級。
名詞小辭典
- Ollama:在自己電腦上下載、執行開源 AI 模型的工具。
- MLX:Apple 為自家晶片設計的機器學習框架,讓 Mac 跑 AI 更有效率。
- 量化(Quantization):把模型的數字壓小,換取更少的記憶體用量與更快的速度,品質會略降。
- 程式碼代理(Coding agent):能讀寫程式碼、跑指令、幫你完成開發任務的 AI 工具。
資料來源
常見問題
MLX 是什麼?
MLX 是 Apple 為自家晶片做的機器學習框架。Ollama 這次加入用 MLX 執行 Gemma 4 的支援,目標是在 Apple 晶片的 Mac 上跑得更順。
ollama launch 是做什麼的?
它可以用一行指令,把 Ollama 的本地模型接到各種程式碼代理工具,並自動設好設定檔。這次新增 Hermes Agent 與 GitHub Copilot CLI。
Hermes Agent 是什麼?
官方的說法是它會跟著你學習,自動建立技能來更貼近你的工作流程,適合研究與工程類任務。啟動方式是 ollama launch hermes。
我需要馬上更新嗎?
如果你在 Mac 上用 Gemma 4,或想用新的整合,可以更新。其他用途沒有硬性理由,先看更新內容再決定。
接著讀
全部觀點 →Ollama 0.30.6 上架 Gemma 4 QAT 版本:同樣的模型,吃更少記憶體就能跑Ollama v0.30.6 新增 Gemma 4 全系列的 QAT(量化感知訓練)權重,標籤以 -qat 結尾,從 e2b 到 31b 共五款,目標是降低記憶體需求、讓模型在自己的電腦上跑得更順。閱讀 →Ollama 0.21.1:一行指令就能啟動 Kimi CLI,Mac 的 MLX 也變快了本地模型工具 Ollama 發布 0.21.1:新增 ollama launch kimi,可直接啟動 Kimi CLI;Mac 的 MLX 執行器加了 logprobs、取樣更快,另外修了 Gemma 4 關閉思考時結構化輸出的錯誤。閱讀 →Ollama 0.40.4:Codex CLI 可以直接挑本機模型,終端機一行指令就能讓 AI 判斷是或否Ollama 0.40.4 讓 ollama launch codex 的模型選單出現本機安裝的模型,決策模型也能直接在終端機用 ollama run 問是非題、分類與評分;另外改善推論效能、支援多模態嵌入,Gemma 4 在 NVIDIA 顯示卡上的前置處理也變快。閱讀 →