觀點 · 資訊分享
Ollama 0.21.1:一行指令就能啟動 Kimi CLI,Mac 的 MLX 也變快了
本地模型工具 Ollama 發布 0.21.1:新增 ollama launch kimi,可直接啟動 Kimi CLI;Mac 的 MLX 執行器加了 logprobs、取樣更快,另外修了 Gemma 4 關閉思考時結構化輸出的錯誤。
- 發布
- 2026-04-22
- 篇幅
- 約 3 分鐘 · 1,199 字
- 結構
- 6 節 + 3 題常見問題
- 標籤
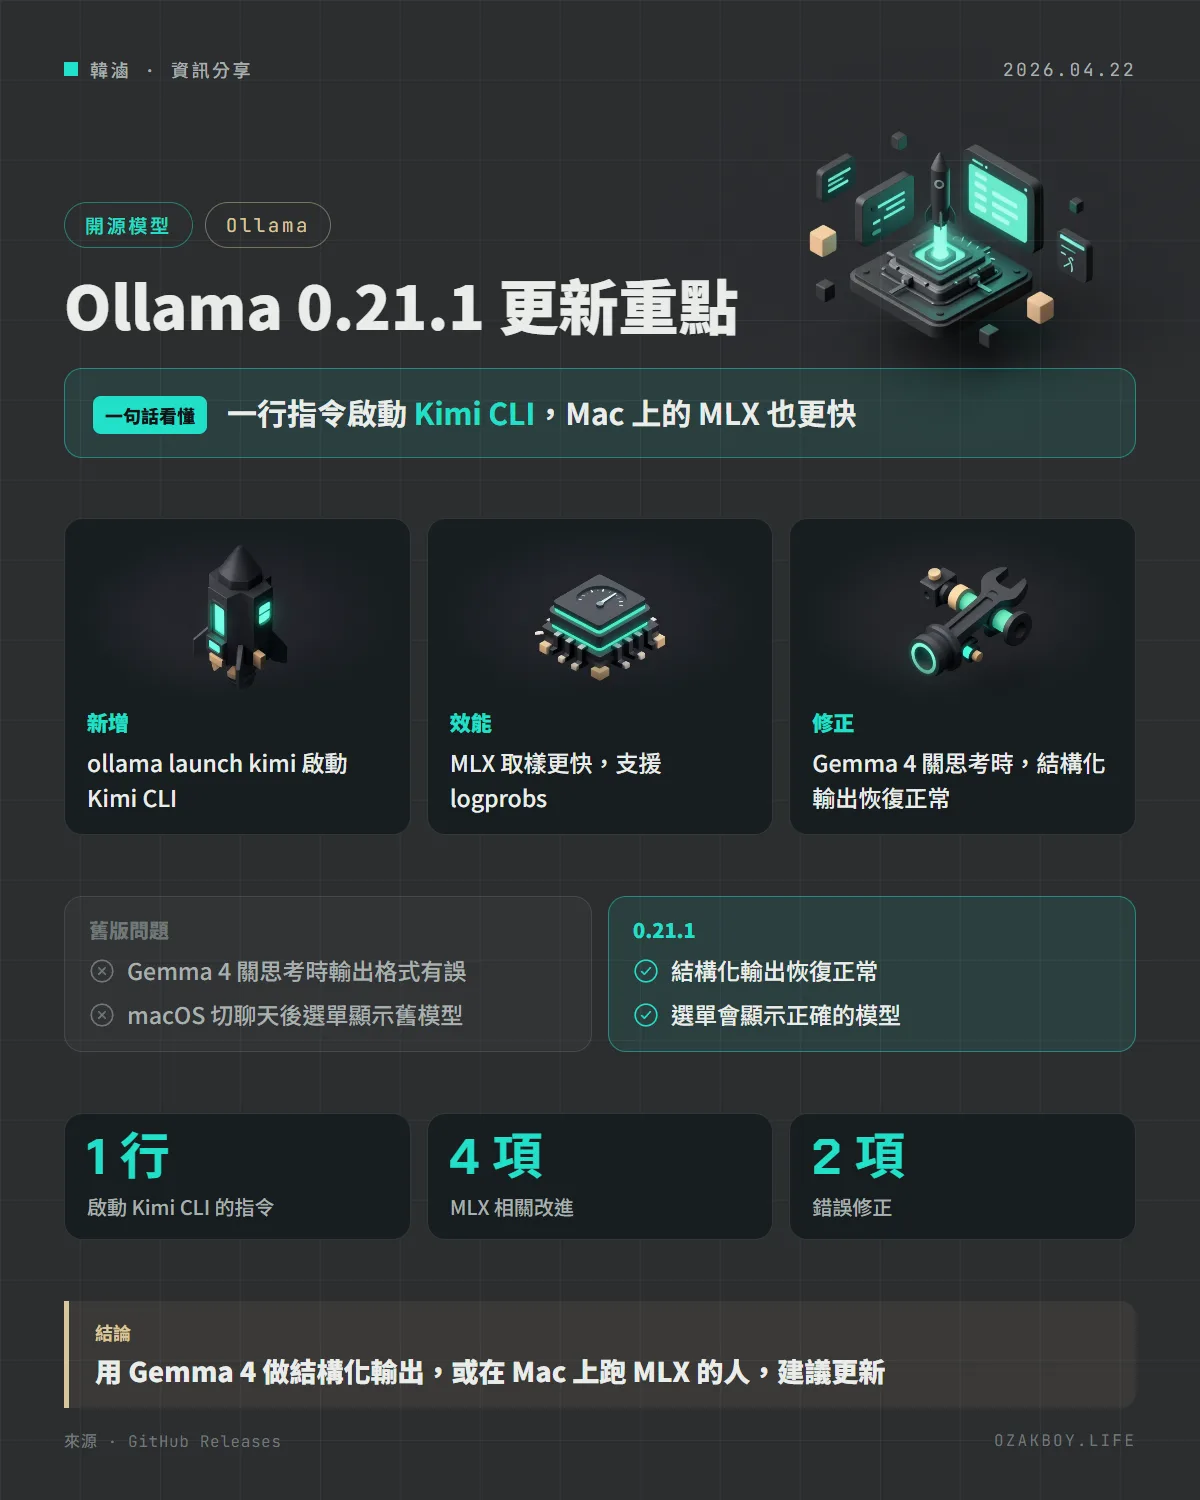
一句話看懂:Ollama 0.21.1 新增一行指令啟動 Kimi CLI,也加快了 Mac 上 MLX 執行器的速度,並修了兩個錯誤。
先用白話講:Ollama 是什麼?
你可以把 Ollama 想成「AI 模型的應用程式商店加播放器」:下載一個開源模型,輸入一行指令就能在自己電腦上跑起來,不必自己處理一堆環境設定。
發生什麼事
Ollama 在 2026 年 4 月 22 日發布 0.21.1,重點有三塊。
新增:Kimi CLI
現在可以透過 Ollama 安裝並執行 Kimi CLI。官方範例指令如下:
ollama launch kimi --model kimi-k2.6:cloud
官方說 Kimi CLI 搭配 Kimi K2.6,擅長需要長時間、多步驟的代理式任務,背後是多代理系統。
效能:MLX 執行器
MLX 是 Apple 為自家晶片做的機器學習框架。這版針對它做了四項改進:
- 支援 logprobs(模型對每個字的信心機率),相容的模型可用
- 取樣更快:把 top-P 與 top-K 合併成一次排序,並把重複懲罰放進取樣器
- 提示詞分詞改到請求處理流程中進行
- 陣列管理的執行緒安全性更好
另外,GLM4 MoE Lite 因為用了融合的路由頭,效能也有提升。
修正
- macOS App 切換聊天後,模型選單會顯示過期的模型
- Gemma 4 在關閉思考(
think=false)時,結構化輸出有誤
給開發者的技術細節
- 範例指令的模型名稱帶有
:cloud字尾;官方這份更新說明沒有進一步解釋,我推測是走 Ollama 雲端的模型,實際行為請看官方文件 - 結構化輸出(讓模型照指定的 JSON 格式回答)是做自動化時很常用的功能,用 Gemma 4 的人升級後可以重跑一次測試
- 完整差異可看官方 v0.21.0 到 v0.21.1 的比較頁
我的看法
自己在用本地模型的人,最怕版本更新後某個功能默默壞掉。這次修的 Gemma 4 結構化輸出就是典型例子:不報錯,只是輸出格式不對,下游程式才爆。如果你的流程依賴固定格式,升級之後建議拿一組固定測試跑一遍。
至於 Kimi CLI,目前官方只給了啟動方式,沒有講費用或使用限制,我會先觀望,等看到更完整的說明再決定要不要放進工作流程。
另外,這版的改進偏向「底層調校」:MLX 的取樣流程精簡後,在 Mac 上跑模型的人理論上會感覺回應更順,但官方沒有附上實測數字,實際快多少要看自己的機器與模型。
名詞小辭典
- Ollama:在自己電腦上執行開源 AI 模型的工具。
- MLX:Apple 專為自家晶片設計的機器學習框架。
- 結構化輸出:要求模型照固定格式(例如 JSON)回答,方便程式處理。
- logprobs:模型對每個輸出字的機率,常用來評估信心程度。
資料來源
常見問題
Ollama 是什麼?
一個可以在自己電腦上下載並執行開源 AI 模型的工具,也提供 API 讓其他程式呼叫。
怎麼啟動 Kimi CLI?
照官方更新說明的範例,執行 ollama launch kimi --model kimi-k2.6:cloud。
MLX 是什麼?
Apple 為自家晶片設計的機器學習框架。這次的改進主要影響在 Mac 上用 MLX 執行器跑模型的人。
接著讀
全部觀點 →Ollama 0.21.0:Mac 可用 MLX 跑 Gemma 4,一行指令啟動 Hermes 與 GitHub Copilot CLI本地模型工具 Ollama 發布 0.21.0:Apple 晶片的 Mac 能用 MLX 跑 Gemma 4,ollama launch 新增 Hermes Agent 與 GitHub Copilot CLI 兩個整合,並修掉幾個建置與設定寫入的問題。閱讀 →Ollama 0.40 在 Mac 上預設改用 MLX:本地跑 Qwen、Gemma 不用再手動切換本地 AI 工具 Ollama 發布 0.40 版,Apple Silicon 的 Mac 上只要模型架構有支援,就會自動用蘋果的 MLX 框架來跑。3 月預覽時官方測得輸出速度約快 1.9 倍。閱讀 →Ollama 0.34.1:模型清單 API 冷啟動從 3.1 秒降到 294 毫秒,自己轉模型的規矩也跟著改了本地 AI 工具 Ollama 發布 0.34.1:模型很多時,列出模型的 /api/tags 快上許多;用 MLX 的 safetensors 建模型不再是實驗功能,但 GGUF 的轉檔與量化要改用 llama.cpp 工具,typical_p 參數也被棄用。閱讀 →