觀點 · 資訊分享
ChatGPT 免費版的健康回答升級:OpenAI 稱有事實問題的回答兩個月少了 71%,數字仍是自家評估
OpenAI 說免費版 ChatGPT 用的 GPT-5.5 Instant,在健康問題上已接近旗艦思考模型。官方用醫師評分表與線上監測佐證,但所有數字都是 OpenAI 自己整理的。
- 發布
- 2026-06-19
- 篇幅
- 約 4 分鐘 · 1,806 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
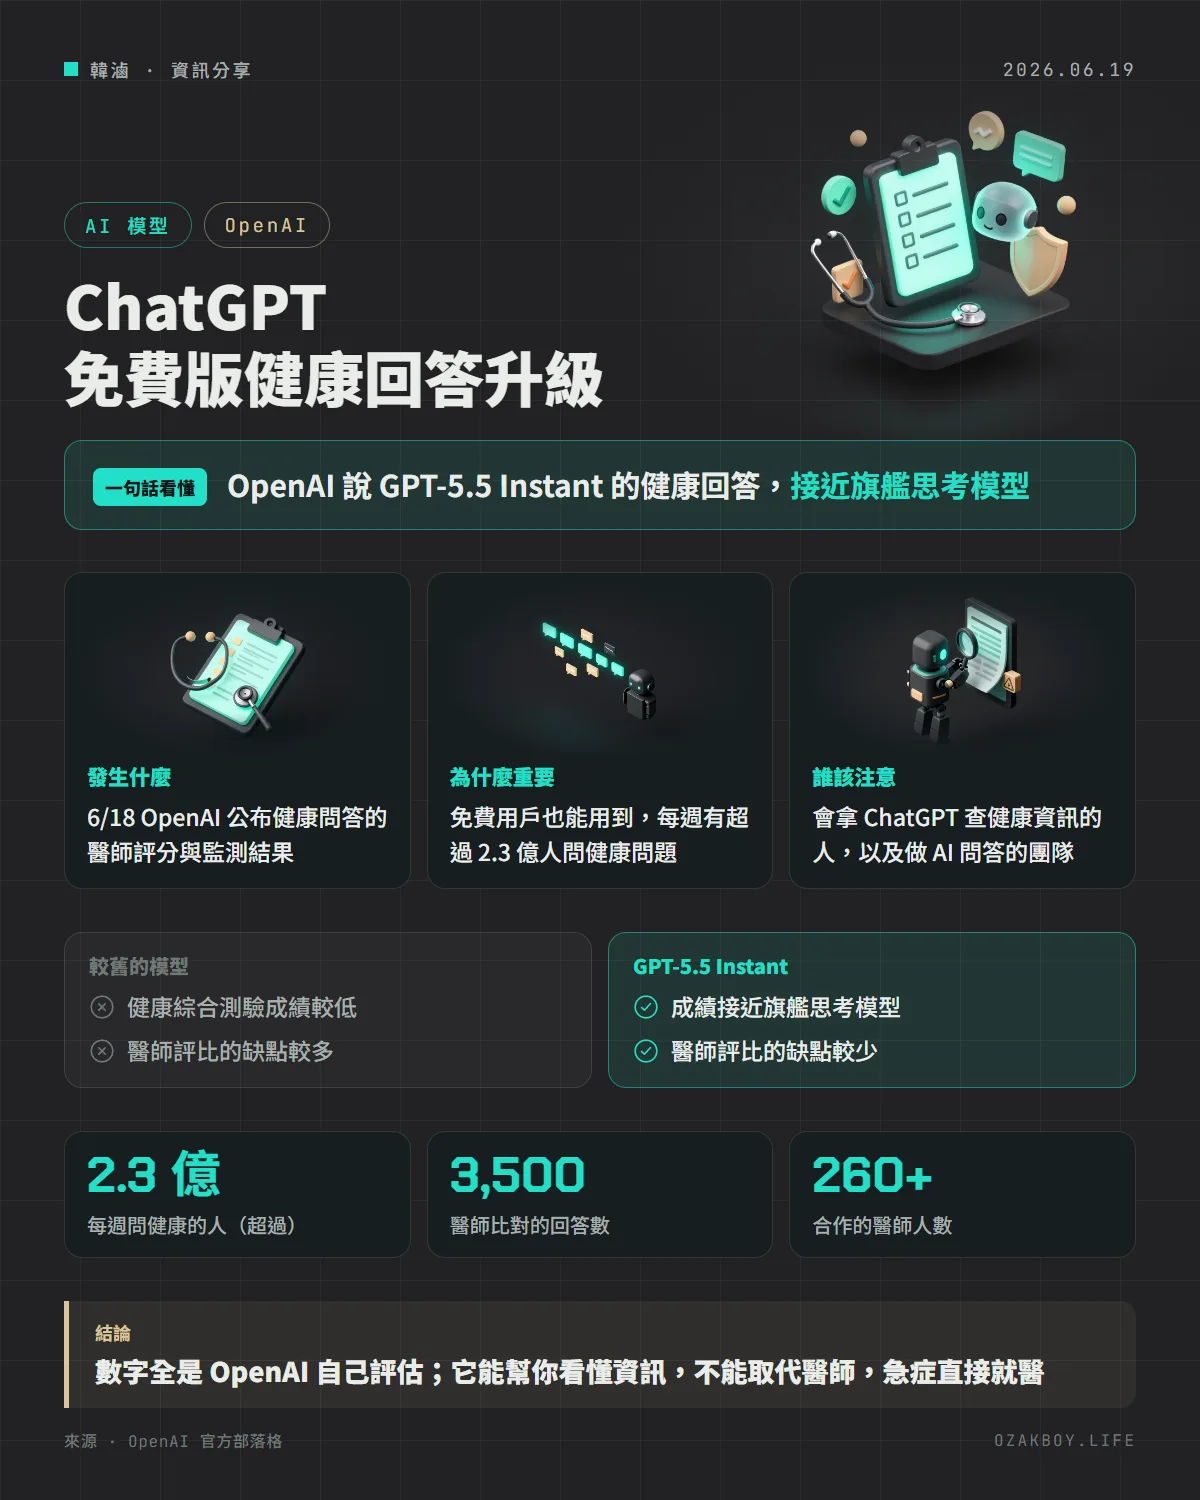
一句話看懂:OpenAI 說免費版 ChatGPT 用的 GPT-5.5 Instant,在健康問題上的表現已接近旗艦思考模型,被標記有事實問題的回答兩個月少了 71%,但這些都是 OpenAI 自己整理的數字。
先用白話講:怎麼判斷 AI 的健康回答變好了?
想像你要判斷一位新來的家教有沒有進步。你不會只問他「你覺得自己進步了嗎?」,而是找老師先寫好評分表,再拿他的作答去對照打分,還會抽查他平常的作業有沒有出錯。
OpenAI 這次做的就是類似的事:請醫師寫「好的健康回答應該長什麼樣子」的評分表,用它去測試模型,再用線上的真實使用狀況做抽查。
發生什麼事
OpenAI 在 6 月 18 日發表文章,主要內容是:
- 模型:GPT-5.5 Instant(官方說 2026 年 5 月推出),所有免費使用者在使用上限內都能用
- 成績:在最困難的健康評測上,官方說表現與旗艦的思考型模型相當,比 GPT-5.3 Instant(官方說 2026 年 3 月推出)進步明顯
- 規模:官方說每週有超過 2.3 億人用 ChatGPT 問健康與保健問題,包括看懂檢驗報告、準備看診、了解保險等
- 進步的面向:更能判斷何時可能需要緊急就醫、會主動追問相關背景、能說明不確定之處,並把複雜資訊講得更清楚
OpenAI 是怎麼量的?
| 衡量方式 | 內容 | 官方說的結果 |
|---|---|---|
| 醫師評分表測驗 | HealthBench 與 HealthBench Professional | 接近最新旗艦模型,比 GPT-5.3 Instant 進步 |
| 醫師評比 | 審閱 3,500 則回答,比較模型與醫師(可上網、不能用 AI)寫的回答 | GPT-5.5 Instant 在各項標準被評得較高 |
| 線上流量監測 | 用隱私保護的監測工具標記可能的事實性問題 | 被標記的回答比例兩個月降低 71% |
另外,官方說合作的醫師超過 260 位,涵蓋 60 個國家、49 種語言、26 個醫學專科,累計審閱超過 70 萬則範例回答。
這些數字怎麼看
- 全部是官方自己的評估:文章沒有外部單位的獨立驗證,評分表與醫師也是 OpenAI 自己合作的
- 71% 不是「正確率」:它是「被監測工具標記有事實問題的回答比例」下降,這個監測工具本身的準確度,文章沒有說明
- 「比醫師的回答評分高」要小心讀:比較對象是醫師在固定題目下寫的文字回答,不是看診,也沒有檢查身體
- 測試的是回答品質,不是診斷能力:官方強調的是幫人看懂資訊、問對問題、知道何時就醫
更多細節
- 可用範圍:GPT-5.5 Instant 與 GPT-5.3 Instant,官方說都開放給所有免費使用者(有使用上限)
- 評測方法:醫師寫的評分表涵蓋準確度、安全、溝通、掌握背景、完整度與適當的轉診建議
- 相關產品線:OpenAI 另有給醫療人員用的 ChatGPT for Clinicians 與 OpenAI for Healthcare,用在文件、研究與照護流程
- 文章沒有說明:這次是否同時調整 API 的模型、各國語言的表現是否一致、評分表是否公開,這些我都沒查到
我的看法
我覺得這篇最值得看的不是 71% 這個數字,而是它把「怎麼把關 AI 品質」寫得很具體:先讓專業的人定義什麼是好回答,再抽樣請人審,最後上線後持續監測。做過客服或問答機器人的人都知道,最怕的就是 AI 很有自信地講錯。
如果你也在幫客戶做 AI 問答功能,這個流程很值得借用:不要只靠自己試幾題就上線,先跟客戶一起列「好回答與壞回答」的清單,上線後抽查紀錄、追蹤出錯的類型。至於當一般使用者,把它當成「幫我看懂資料、準備問醫生的問題」的助手就好,有症狀或急症,還是直接去看醫生。
名詞小辭典
- GPT-5.5 Instant:ChatGPT 免費版可用的模型,官方說它在健康問題上已接近旗艦的思考型模型。
- HealthBench:用擬真的健康對話搭配醫師寫的評分標準,來測試 AI 回答品質的評測。
- 事實性問題(Factuality Issue):AI 回答中出現與事實不符、或無法被支持的內容。
- 評分表(Rubric):事先寫好的評分標準,用來判斷一個回答在準確、安全、清楚等面向表現如何。
資料來源
常見問題
GPT-5.5 Instant 是什麼?
它是 ChatGPT 免費版使用者能用的模型之一,OpenAI 說它在 2026 年 5 月推出。這次公告重點是它在健康問題上的表現進步。
OpenAI 是怎麼衡量「健康回答變好」的?
用了三種方式:以醫師寫的評分表做的健康測驗(HealthBench 與 HealthBench Professional)、請另一組醫師比較模型與醫師寫的回答,以及用隱私保護的監測工具抽查實際流量中的事實性問題。
71% 是什麼意思?
官方說,比較最近的健康類流量(每週數十億則訊息),被標記為至少有一處事實問題的回答比例,在最近兩個月降低了 71%。這是 OpenAI 自己監測工具的結果,不等於回答的正確率。
可以用 ChatGPT 取代看醫生嗎?
不行。文章沒有說它能取代醫師,官方描述的用途是幫人看懂資訊、準備看診,以及判斷何時該就醫。身體不適或有緊急症狀,請直接尋求專業醫療協助。
接著讀
全部觀點 →GPT-6 開放給所有 ChatGPT 使用者:回答會變成可點的圖表與小工具,搜尋類問題快 44% 開始回答OpenAI 把 GPT-6 帶給每週超過 12 億人使用的 ChatGPT,並推出 Intelligent UI:回答不只是文字,還能出現互動圖表、按鈕、表單,甚至當場做出計算機。付費方案先上,免費與 Go 方案隔天開始。閱讀 →OpenAI 開始替 AI 文字加隱形浮水印:歐盟 ChatGPT 先上,換掉 25% 用詞偵測率剩 17%為了因應歐盟 AI 法案,OpenAI 推出文字浮水印技術 textGrain:歐盟的 ChatGPT 與 Codex 輸出將加入看不見的統計訊號,API 用戶可以自選開啟。但官方也坦白,文字一短、一改寫,偵測率就大幅下降。閱讀 →ChatGPT 免費版換成 GPT-5.6 Luna、下週起文字聊天不限次數:Sol 也調整,OpenAI 自測錯誤少約 68%OpenAI 在 8 月 6 日更新 ChatGPT:Plus 與 Pro 的 GPT-5.6 Sol 多了思考滑桿,免費與 Go 用戶的預設模型換成 GPT-5.6 Luna,下週起文字聊天不限次數。閱讀 →