觀點 · 資訊分享
Claude Opus 5 登場:價格和 Opus 4.8 一樣,成績逼近旗艦 Fable 5,成本只要約一半
Anthropic 發表 Claude Opus 5,API 價格維持每百萬 token 輸入 5 美元、輸出 25 美元。官方說它的程式與知識工作表現達到新高,但資安攻擊類能力仍落後 Mythos 5。
- 發布
- 2026-07-24
- 篇幅
- 約 4 分鐘 · 1,713 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
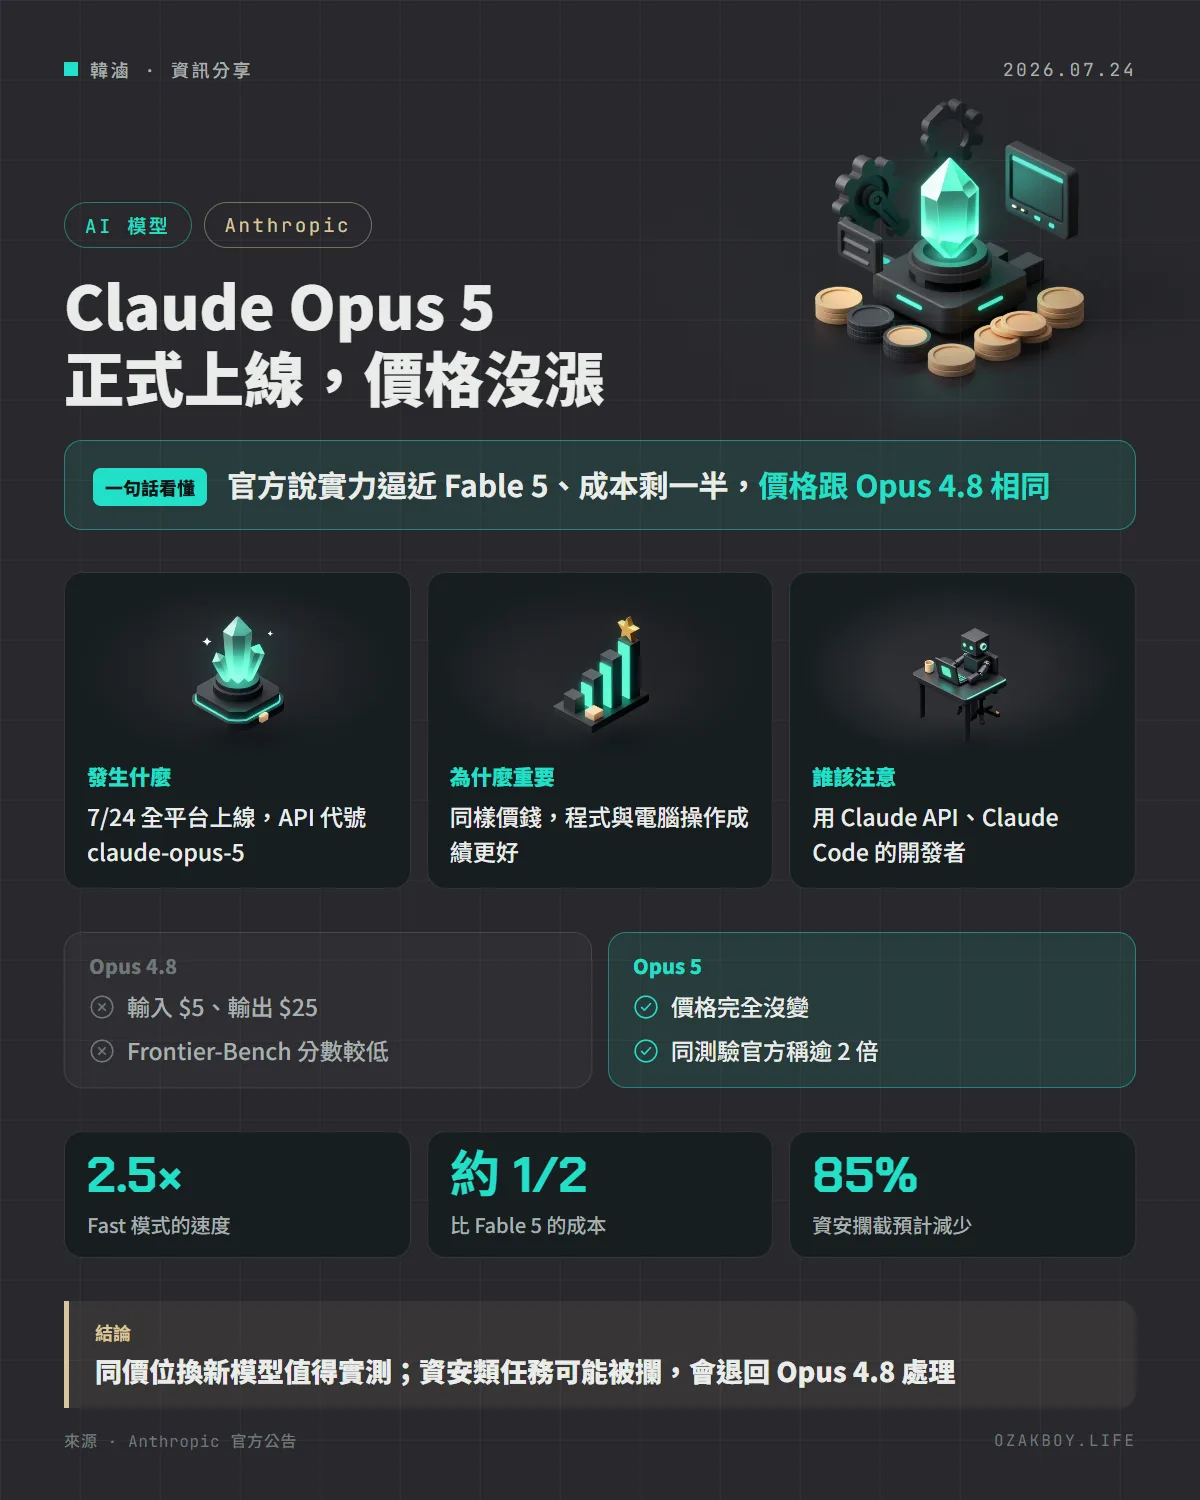
一句話看懂:Anthropic 推出 Claude Opus 5,價格跟 Opus 4.8 一模一樣,但官方說它在程式、知識工作與電腦操作的成績都創新高,實力逼近旗艦 Fable 5,成本卻只要約一半。
先用白話講:Opus 是什麼等級?
Anthropic 的 Claude 模型像一個產品線:Mythos、Fable、Opus、Sonnet、Haiku 各自定位不同,越強的模型通常越貴。Opus 這一檔,官方說 Opus 5 是設計成每天都能用的:夠聰明,又不像旗艦那麼貴。
這次 Opus 5 的賣點是「平價版逼近旗艦」。就像一款新的中階手機,規格幾乎追上去年的旗艦機,價格卻跟上一代中階機一樣。
發生什麼事
- 上線:7 月 24 日全平台可用,API 代號
claude-opus-5 - 價格:每百萬 token 輸入 5 美元、輸出 25 美元,與 Opus 4.8 相同
- Claude 應用程式:成為 Claude Max 的預設模型,也是 Claude Pro 上最強的模型
- Fast 模式:速度約為預設的 2.5 倍,價格是基本價的兩倍
官方形容 Opus 5「接近 Fable 5 的智力、價格只有一半」。在寫程式與知識工作的評測 Frontier-Bench、GDPval-AA 上,官方稱它是目前最高分,但資安類任務仍落後 Mythos 5。
官方給的成績單
| 評測 | 官方說法 |
|---|---|
| Frontier-Bench v0.1(程式) | 超過所有模型,成績是 Opus 4.8 的兩倍以上,每項任務成本更低 |
| CursorBench 3.2(最高思考力) | 與 Fable 5 最高分只差 0.5% 以內,每項任務成本約一半 |
| ARC-AGI 3(新題型推理) | 分數是第二名的三倍 |
| Zapier AutomationBench | 通過率約為第二名的 1.5 倍,每項任務成本相同 |
| OSWorld 2.0(電腦操作) | 超越 Fable 5 的最佳成績,成本只要略高於三分之一 |
以上都是 Anthropic 自己公布的數字,實際表現還是要看你的任務。
安全與防護:哪些會被擋?
官方稱 Opus 5 是目前「最對齊」的模型:自動化行為稽核中,整體偏離行為的分數是 2.3,是近期模型裡最低。資安方面,Opus 5 找漏洞的能力接近 Mythos 5,但把漏洞變成實際攻擊的能力差很多;官方還刻意沒有針對資安任務訓練它。
- 允許:在原始碼中找漏洞
- 擋下:二進位弱點掃描、滲透測試、攻擊程式生成
- 預估比 Fable 5 少攔約 85%;被攔的請求在 Claude 應用程式與 Claude Code 預設退回 Opus 4.8,API 也可以開啟這項自動退回
給開發者的技術細節
同一天還有兩項 beta 功能:
- 對話中途更換工具:在 Claude Platform 上,同一段對話中可以改變 Claude 能用的工具,而不會讓提示快取失效
- API 自動退回:被安全分類器攔下的請求可自動轉給其他模型,而不是直接被擋
另外,官方說明 Opus 5 一般使用沒有資料保留的要求,與先前的 Opus 模型一致。
我的看法
對小團隊來說,這次最有感的是「同價升級」:不用重新談預算,換個模型代號就有機會拿到更好的結果。但我不會只看官方圖表就全面切換,因為各家評測偏好的任務型態不同;比較務實的做法,是拿自己最常跑、最容易出錯的幾個任務,用 Opus 5 與現在在用的模型各跑一遍,比對成功率與花費。
另一個要留意的是資安類任務:如果你的工作會碰到漏洞掃描或滲透測試,Opus 5 可能被攔下並退回舊模型,結果會跟預期不同。需要這類功能的團隊,可以研究官方的 Cyber Verification Program。
名詞小辭典
- Token:AI 計算文字量的單位,API 依 token 數量收費。
- Benchmark(評測):一組標準題目,用來比較不同模型的表現。
- 提示快取(Prompt Cache):把重複送出的固定內容先存起來,之後再用就更快更便宜。
- Fast 模式:用較貴的價格換取更快的回應速度。