觀點 · 資訊分享
SGLang 0.5.16:新推測解碼 DSpark 讓 DeepSeek-V4-Pro 單請求每秒 383.7 token
開源推理引擎 SGLang 釋出 0.5.16,加入依信心調整猜字長度的 DSpark 推測解碼,支援 975B 參數的 Inkling 模型,也有省記憶體的新選項。同時移除多個量化路徑,升級前要看破壞性變更。
- 發布
- 2026-07-26
- 篇幅
- 約 3 分鐘 · 1,557 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
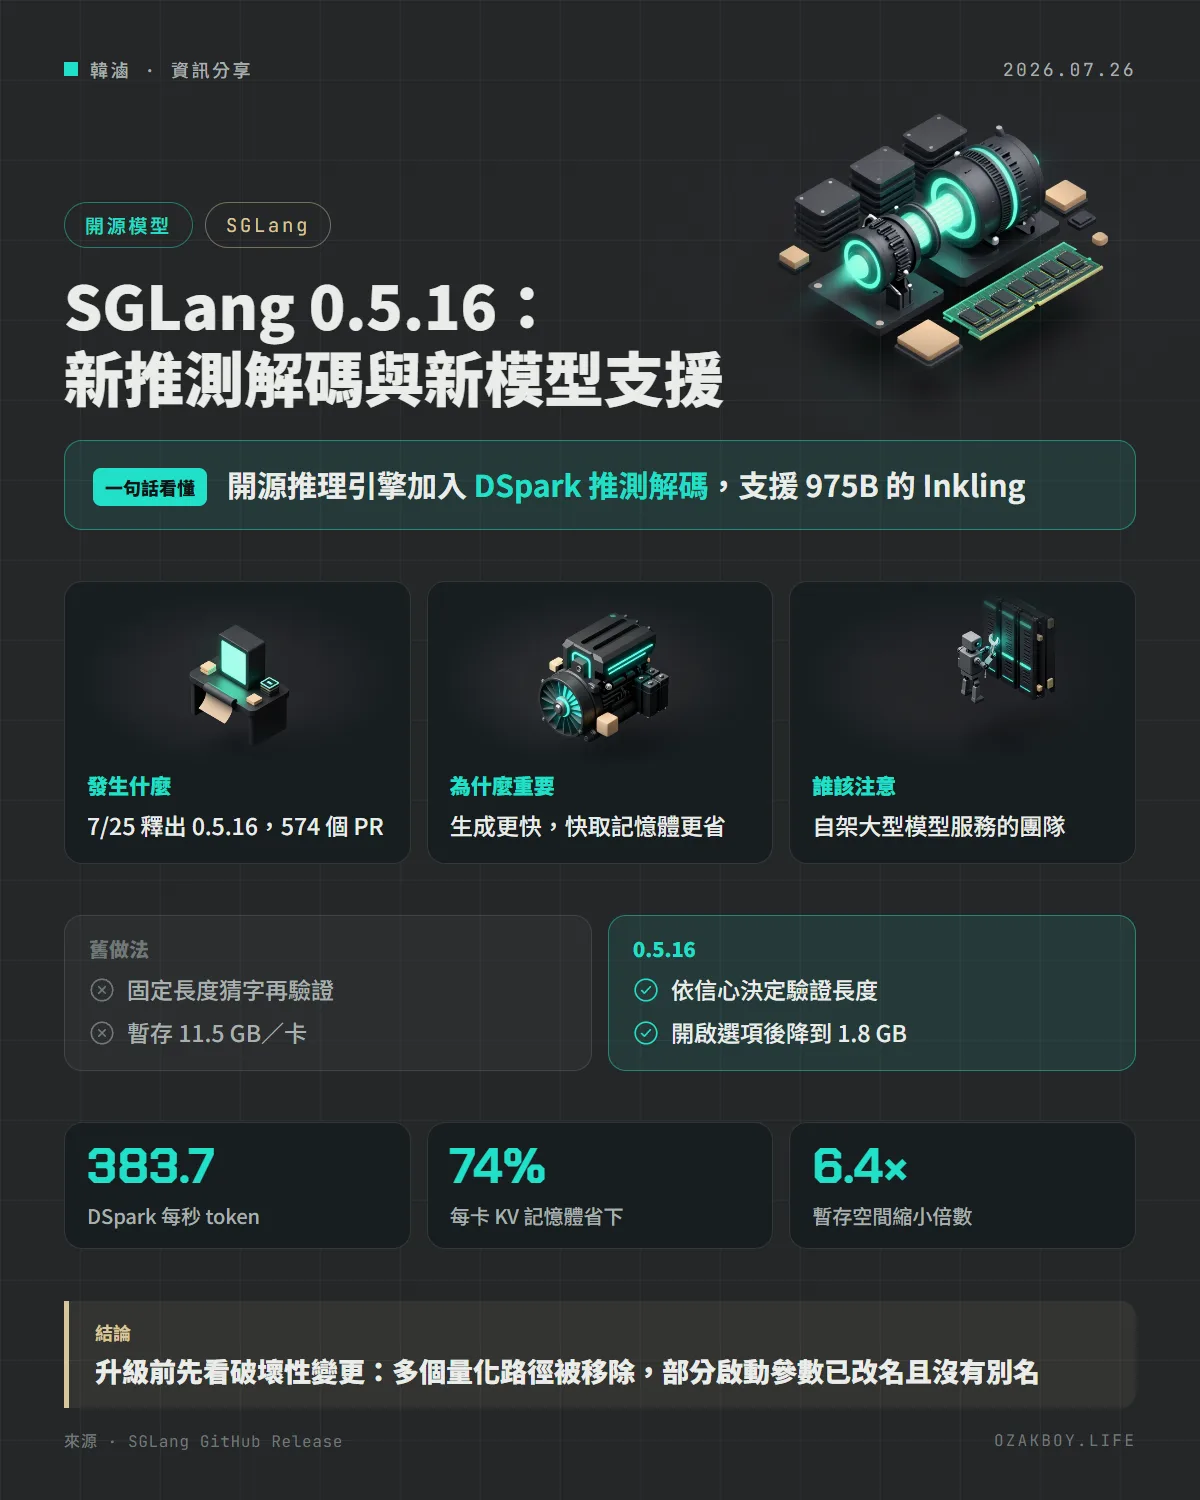
一句話看懂:開源推理引擎 SGLang 釋出 0.5.16,加入會「看信心決定檢查長度」的新推測解碼 DSpark,支援 975B 參數的 Inkling 模型,但也移除了幾個舊的量化路徑,升級前要先看清楚。
先用白話講:推測解碼是什麼?
想像大模型是一位很嚴格但動作很慢的老師,每次只能批改一個字。推測解碼的做法是:先請一位反應快的助教,一口氣猜出接下來好幾個字,老師再一次檢查,猜對的就直接採用,猜錯的再重寫。這樣老師的工作量就少很多。
舊做法是助教每次固定猜幾個字。DSpark 的新意是:助教對答案有多有把握,就決定這次讓老師檢查多長,把握大就檢查長一點,沒把握就短一點。
發生什麼事
SGLang 在 7 月 25 日(UTC)釋出 0.5.16,官方說明包含 574 個 PR、169 位貢獻者。重點有這些:
- DSpark 推測解碼:官方數據是 DeepSeek-V4-Pro 在 8 張 B300 GPU、單一請求下,平均接受長度約 5 時,每秒達 383.7 token
- Inkling 支援:975B 參數的多模態 MoE 模型,上下文長度 100 萬 token;在 Blackwell 上,輸入最高每秒 7.17 萬 token,單一使用者解碼每秒 171.0 token
- 其他新模型:LongCat 2.0 FP8、JetBrains Mellum v2、機器人模型 Pi0.5、影像擴散模型 LongLive 2.0
- UnifiedRadixTree 成為預設:針對 SWA、Mamba 與 DSA 類模型的快取結構
省記憶體的新選項
| 功能 | 官方數據 | 備註 |
|---|---|---|
| GLM-5.2 的 DSA 快取分層 | 每張卡的 KV 記憶體降約 74%(0.77 GB 降到 0.20 GB) | 以 8192 token、cp_size=4 測試,需另外開啟選項 |
| ReplaySSM Ring Spec-Verify | 暫存空間從 11.5 GB 降到 1.8 GB(縮小 6.4 倍) | 以 Qwen3.5-35B-A3B、單卡測試,預設關閉 |
給開發者的技術細節
開啟 DSpark:
--speculative-algorithm DSPARK
# 並設定環境變數 SGLANG_RAGGED_VERIFY_MODE=compact
# 可用 --speculative-dspark-block-size 調整區塊大小
官方列出的破壞性變更包括:
- 移除 QServe(QoQ)W4A8 與 FBGEMM FP8 量化路徑
- 移除
--fp4-gemm-backend cutlass,NVFP4 GEMM 現在需要 FlashInfer --enable-deepep-waterfill改名為--enable-waterfill,--optimistic-prefill-retries改名為--optimistic-prefill-attempts,兩者都沒有舊名稱別名,沿用舊參數會出現無法辨識的錯誤- SGLang-Diffusion 的後訓練回傳端點改回傳 msgpack,而不是 JSON
官方也列出已知問題,例如在特定設定下,溫度為 0 的相同請求結果可能不一致。
我的看法
這版的數字多半是在 B300 這種資料中心等級的顯示卡上量的,家用電腦不會直接感受到。但推測解碼、省 KV 快取這些技術,是整個推理引擎圈都在追的方向,值得知道名字。
如果你自己在維護模型服務,最該做的是先讀「破壞性變更」:參數改名且沒有別名,是會讓啟動指令直接報錯的那種。建議先在測試環境用舊的啟動指令跑一遍,確認沒問題再升級正式環境。
名詞小辭典
- 推理引擎:負責把訓練好的模型實際跑起來、回答問題的軟體。
- KV 快取:模型回答時暫存前面內容的記憶區,越長的對話越吃記憶體。
- MoE(混合專家):模型分成很多「專家」,每次只啟動其中一部分,省算力。
- Token:AI 計算文字量的單位。
資料來源
常見問題
SGLang 是什麼?
一套開源的大型語言模型推理引擎,負責讓模型在 GPU 上跑得更快、更省資源,常見用途是自己架設模型服務的團隊。
推測解碼是什麼?
先讓一個小而快的草稿模型猜接下來的幾個字,再讓大模型一次檢查,猜對的就直接採用,猜錯的才重做,這樣能少跑幾次大模型。DSpark 的新意是:每次要檢查多長,由草稿自己的信心決定,而不是固定長度。
個人用 Ollama 的人需要在意嗎?
這版的數據多半針對資料中心級的 GPU,例如 B300。一般家用電腦不會直接用到,但這類技術通常是推理引擎競相導入的方向,之後可能在其他工具看到類似功能;這點屬於推測,目前官方沒有說明。
接著讀
全部觀點 →DeepSeek V4.1 Flash 小改版開源:Terminal-Bench 從 31.2 跳到 42.3,輸出還變短DeepSeek 推出 V4.1-Flash-1017,以 MIT 授權開放權重,多項跑分提升、完成任務更快、輸出更短。API 名稱 deepseek-flash 已指向新版,離峰時段每百萬輸出 token 只要 0.6 美元。閱讀 →德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。閱讀 →Cloudflare 開源 Clef 決策模型:不寫文章只回機率,9B 版本中位數延遲 38 毫秒Cloudflare 推出第一批自己訓練的開源模型 Clef 與 Clef-flash。它們不產生文字,而是針對你給的問題直接回答「是的機率多少」「選哪個選項」,適合分類工單、擋不該做的動作。權重以 Apache 2.0 釋出,也能在本機跑。閱讀 →