觀點 · 資訊分享
Seedance 2.5 登場:AI 影片單次從 15 秒拉長到 30 秒,最多能參考 30 張圖、10 段影片、10 段音檔
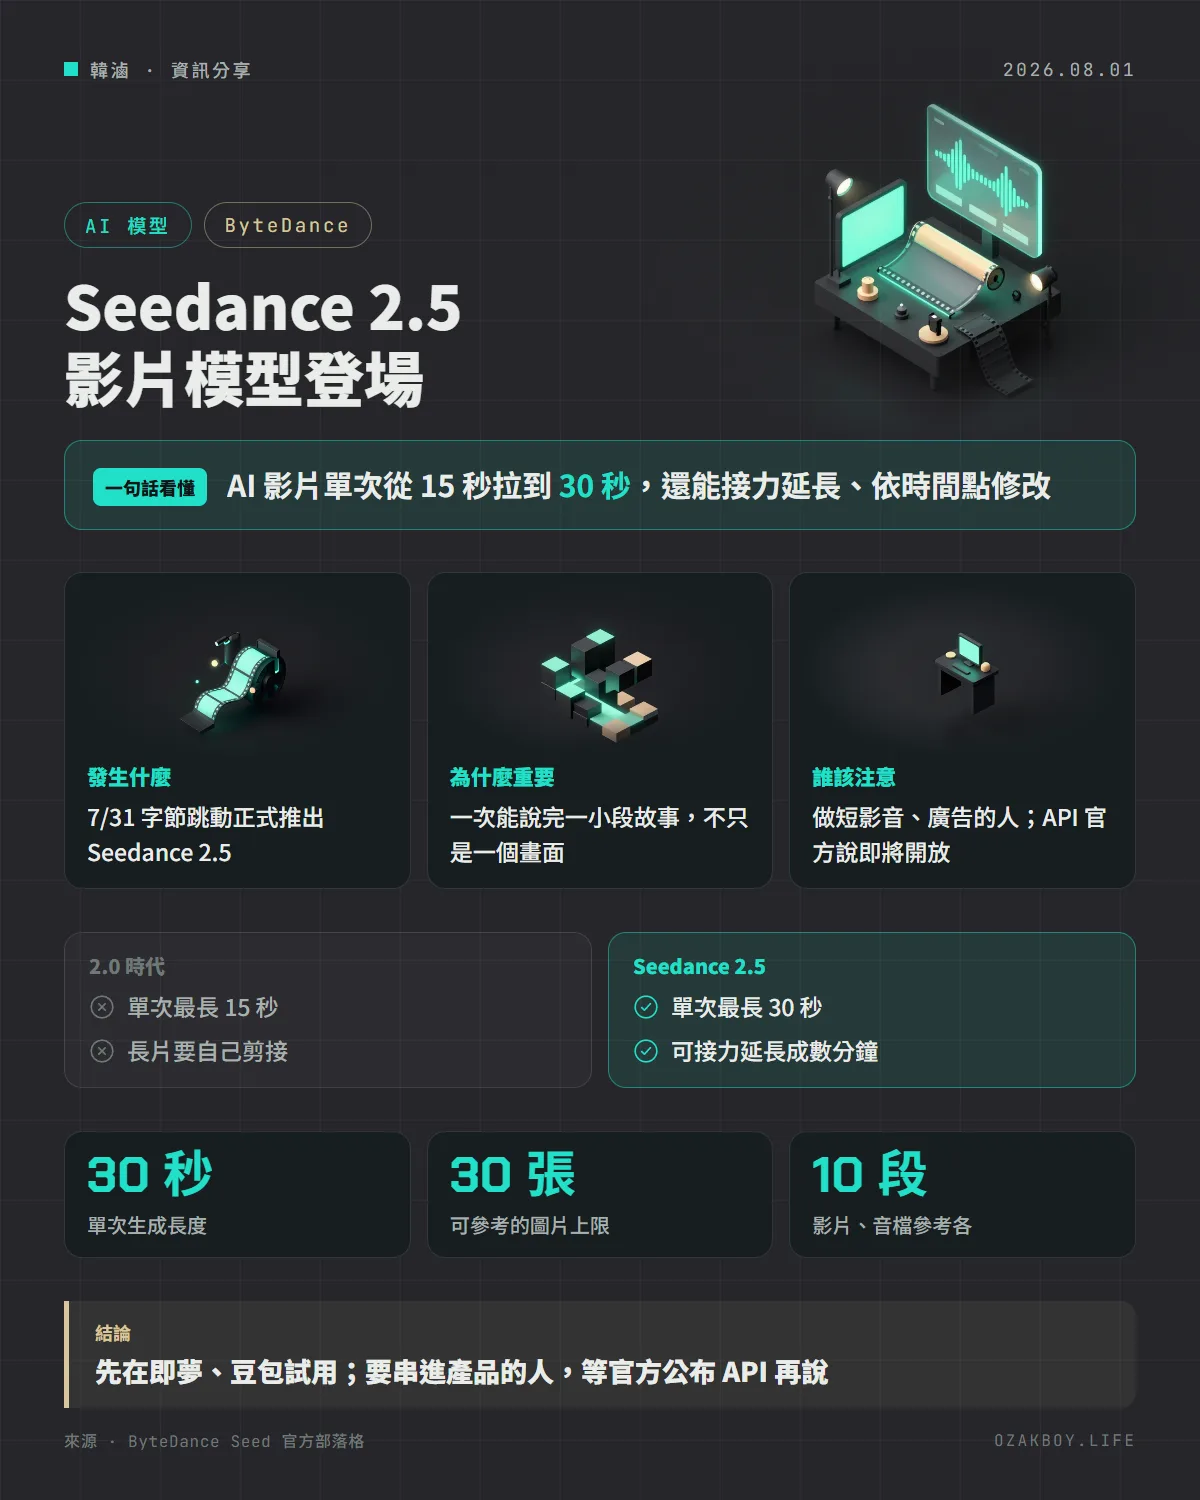
ByteDance Seed 團隊在 7 月 31 日正式推出影片生成模型 Seedance 2.5:單次可生成 30 秒有聲影片、能多次接力延長,也支援依時間點局部修改。目前在即夢與豆包上線,API 官方說「即將」開放。
- 發布
- 2026-08-01
- 篇幅
- 約 3 分鐘 · 1,569 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:字節跳動的 Seedance 2.5 把 AI 影片單次生成長度從 15 秒拉到 30 秒,還能接力延長成數分鐘,並支援參考大量素材與依時間點局部修改。
先用白話講:AI 影片模型的「參考素材」是什麼?
你要請一位導演拍短片,光說「拍一個歌手走上舞台」太籠統。比較好的做法是給他參考:這是歌手的照片、這是我想要的運鏡、這是我想要的音樂。導演看完參考,才知道你要什麼。
AI 影片模型也是一樣。你除了打字,還能丟圖片、影片、音檔給它當「參考」,它會把這些特徵用進新的影片裡。Seedance 2.5 的重點,就是一次能看更多參考、拍更長的片、事後也更好修改。
發生什麼事
ByteDance Seed 團隊在 7 月 31 日正式推出 Seedance 2.5,官方列出三個主要進步:
| 面向 | 做了什麼 |
|---|---|
| 長度 | 單次生成從 15 秒延長到 30 秒,可多輪接力延長,官方說能做出數分鐘的長片 |
| 參考素材 | 一次最多 30 張圖片、10 段影片、10 段音檔 |
| 編輯 | 能依「時間點」局部修改音訊與影像,也強化綠幕、視角調整、依參考編輯 |
官方特別強調「說故事」:30 秒內,模型能排出有起承轉合的多個鏡頭,而不只是把一個畫面拉長。示範是一個一鏡到底的演唱會片段,從後台化妝間、走廊、遇到舞者,一路走上舞台。
比較特別的地方
- 接力延長:在既有影片後面接新的鏡頭,官方說能維持主角、場景與節奏的一致,省掉自己切片、拼接、修轉場的功夫
- 白模參考(Clay render):你可以先用沒有貼圖的簡單 3D 模型,排好空間、角色姿勢、動線與鏡頭角度,模型再照這個結構生成影片,光線方向與陰影也會參考這些空間資訊
- 更像真拍:官方說針對材質、皮膚與眼睛、光線、色彩飽和度做了優化,並減少模型自己亂加字幕與背景音樂的情況
在哪裡用?
官方說明:目前在即夢 AI、豆包 Pro 等平台逐步開放,進入影片生成後選擇 Seedance 2.5 即可。API 會經由 BytePlus ModelArk 提供,官方的說法是「即將」,公告當天沒有給出日期與價格。
給開發者的技術細節
- 公告提供的是產品入口,沒有 API 參數、計價與限制,所以現在還不能串進自己的服務
- 官方展示的 prompt 有幾種寫法:文字生影片(T2V)、用參考素材生成(R2V),其中會用「@圖片 1」「@影片 1」這類標記指定素材的用途,也可以用「0 到 5 秒、6 到 10 秒」這樣的時間段去安排鏡頭
- 官方範例都是廠商挑選的成功案例,實際穩定度要自己測
我的看法
做網站的人最容易遇到的需求是:客戶要一段幾秒到幾十秒的短片放首頁或社群。過去 AI 影片要拼出 30 秒,得靠好幾段拼接,風格還容易跑掉。單次 30 秒、能接力延長,對這種需求確實是實用的進步。
不過我會抱著保留的態度。原因是公告給的都是官方挑選的範例,而且參考素材一多,模型是否真的都照做,要自己試過才知道。另外,官方列出的入口是即夢與豆包,API 也還沒開,台灣的小團隊要放進正式流程,得先確認帳號、付費與商用授權的條件,這些公告都沒有說明。
名詞小辭典
- 多模態參考:用文字以外的素材,例如圖片、影片、聲音,告訴模型想要的樣子。
- 音畫同步生成:影片的畫面與聲音由同一個模型一起生出來,而不是事後另外配音。
- 一鏡到底(One-take):沒有剪接點,鏡頭連續移動拍完一整段。
- API:讓程式呼叫模型的介面,開放之後才能把它整合進自己的網站或系統。