觀點 · 資訊分享
MiniMax 發表 H3 影片模型:2K 畫質、自帶立體聲,圖片影片聲音都能當參考,還預告幾天內開放權重
MiniMax 在 7 月 31 日推出影片生成模型 H3,能同時讀懂文字、圖片、影片與聲音,輸出最長 15 秒、2K 畫質、附原生立體聲的影片。官方也預告,將在幾天內開放模型權重。
- 發布
- 2026-07-31
- 篇幅
- 約 3 分鐘 · 1,398 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
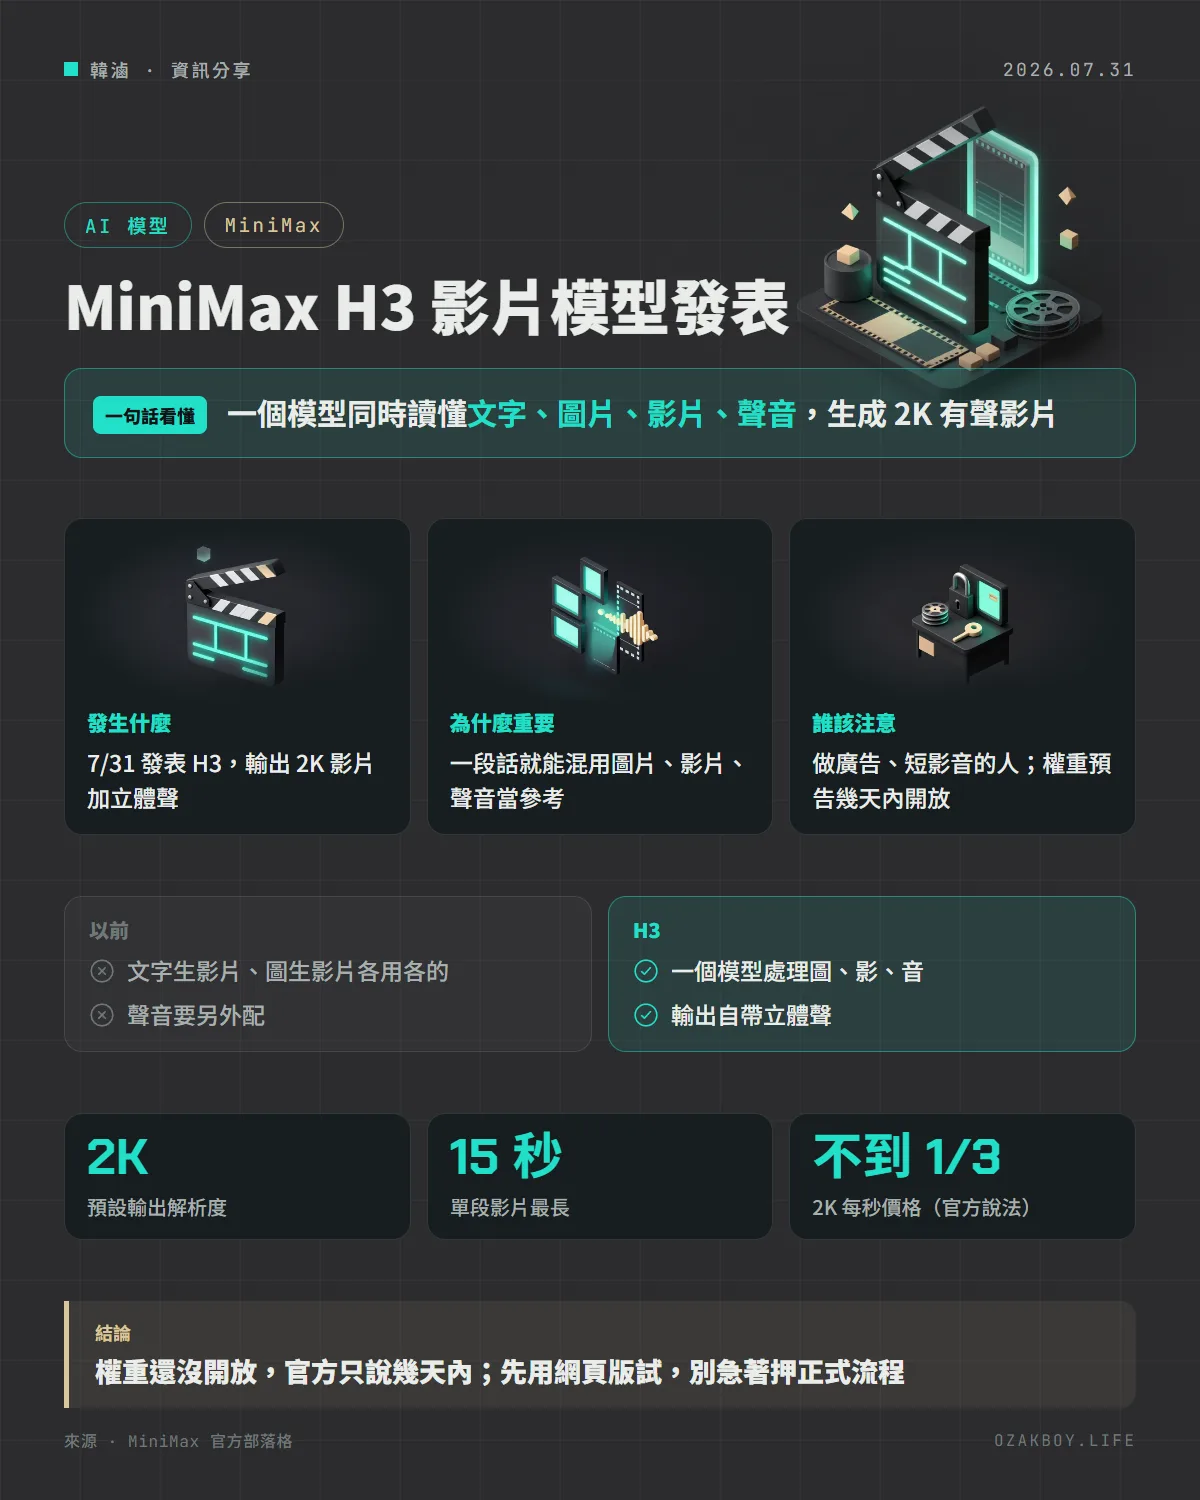
一句話看懂:MiniMax 發表影片模型 H3,一個模型就能同時看懂文字、圖片、影片與聲音,直接生出 2K 畫質、附立體聲的影片,還預告幾天內開放權重。
先用白話講:AI 影片模型在做什麼?
你可以把 AI 影片模型想成一位「聽得懂你說話的剪接師」。你告訴他想要什麼畫面,他就自己生出一段影片。
以前這位剪接師常常要分很多個專業窗口:文字轉影片找一位,用圖片當參考找另一位,要配聲音又得再找別人。MiniMax 說,H3 想改變這件事:同一位剪接師,把文字、圖片、影片、聲音都一起看懂。
發生什麼事
MiniMax 在 7 月 31 日發表 H3,官方稱它是「通用的多模態生成模型」:
- 輸入:文字、圖片、影片、聲音都能一起當參考
- 輸出:最長 15 秒、2K 解析度、附原生立體聲的影片
- 用法舉例:官方示範的指令是「參考影片 1 的運鏡、讓圖片 2 的角色唱歌、歌聲照音檔 3」,一段話就把三種素材組在一起
- 用途:廣告、品牌、電商、產品設計、遊戲等商業內容
價格與開放
官方說得比較大聲的有兩點:
- 預設就是 2K。2K 每秒的價格,不到主流模型的三分之一;768p 的每秒價格,也不到主流模型 720p 的一半。要注意這是 MiniMax 自己的比較說法,公告沒有附詳細的比較表
- 官方預告「在接下來幾天」開放模型權重,目的是讓開源社群與更多 AI 硬體更容易相容、也方便使用者做自己的版本,並且「受適用法規限制」。7 月 31 日當天,這件事還只是預告
它是怎麼做到的?
公告列了幾個技術點,挑最好懂的說:
- H3-VAE:新的影像壓縮器,官方說有效序列長度增加 4 倍,成本更低,也是原生 2K 的關鍵
- 脈絡內重新生成:2K 畫質不是靠另外的放大模組,而是讓模型自己把低解析度結果「再畫一次」,想把小字和細節找回來
- 訓練效率:把理解與生成的運算拆開,訓練吞吐量提升接近 30%
給開發者的技術細節
- 公告提供的是 Hailuo 網頁版體驗連結;沒有提到 API 規格或計價,要整合進產品的人先別假設有
- 開放權重要等官方實際釋出,才能確認授權條款、模型大小與硬體需求;目前能確認的只有「預告」
- 完整技術報告官方也說會「很快」公布
我的看法
對做網站的人來說,影片模型最可能的用途是首頁背景、商品介紹這類短動態素材。對這類需求,H3 最吸引我的不是 2K,而是「用文字說明素材之間的關係」這個做法:你不用先把素材剪好,只要說「這張圖的人、那段影片的動作」。
我會把這次當成觀察,不急著投入。原因有三:價格比較是廠商自己說的;權重還沒開放;API 也沒有公布。如果你想像文字模型那樣在本地跑,要等權重釋出後看模型大小。影片模型通常很吃顯示卡,家用 NAS 可能跑不動,不過這只是我的推測,要等官方數據才算數。
名詞小辭典
- 多模態(Multimodal):模型能同時處理不同種類的資料,像文字、圖片、影片、聲音。
- 開放權重(Open weights):公開模型訓練完的參數,讓別人可以下載來自己執行或微調。
- 原生立體聲:影片的聲音是模型一起生成的,而不是事後另外配上去。
- VAE:把影像壓縮成較小的資料、再還原的技術,常用來降低影片模型的運算成本。
資料來源
常見問題
MiniMax H3 是什麼?
是 MiniMax 做的影片生成模型,特色是同一個模型能處理文字、圖片、影片、聲音的輸入,輸出附有立體聲的 2K 影片,單段最長 15 秒。
現在可以下載來自己跑嗎?
還不行。官方在 7 月 31 日的公告裡說,計畫在接下來幾天開放模型權重,而且要看適用法規;公告當天沒有提供下載。
怎麼試用?
官方公告附了 Hailuo 網頁版的體驗連結,可以直接在網頁上試。公告沒有說明 API 的規格與計價。
接著讀
全部觀點 →Seedance 2.5 登場:AI 影片單次從 15 秒拉長到 30 秒,最多能參考 30 張圖、10 段影片、10 段音檔ByteDance Seed 團隊在 7 月 31 日正式推出影片生成模型 Seedance 2.5:單次可生成 30 秒有聲影片、能多次接力延長,也支援依時間點局部修改。目前在即夢與豆包上線,API 官方說「即將」開放。閱讀 →Meta 開放 816B 參數的 Muse Spark Open:兩台 Mac Studio 跑得動,但綜合指標仍不及中國開源模型Meta 釋出開放權重模型 Muse Spark Open,總參數 816B、每次啟用 42B、支援 100 萬 token 上下文與圖片影音輸入。官方示範用兩台 Mac Studio 執行,商用要標示來源,大型 API 業者另有營收門檻。閱讀 →DeepSeek 開放會看圖的 V4 Flash 實驗版權重:MIT 授權,官方範例要 4 張 GB300 才跑得動DeepSeek 在 8 月 31 日把 V4 Flash 的視覺實驗版放上 Hugging Face,採 MIT 授權。官方公布的圖文任務分數比純文字版高,但官方範例得用 4 張 GB300 的單機節點,一般人只能先看看。閱讀 →