觀點 · 資訊分享
Qwen3.8-Max 上線 QwenCloud:2.4 兆參數的旗艦模型,支援 100 萬 token,用 OpenAI 介面就能呼叫
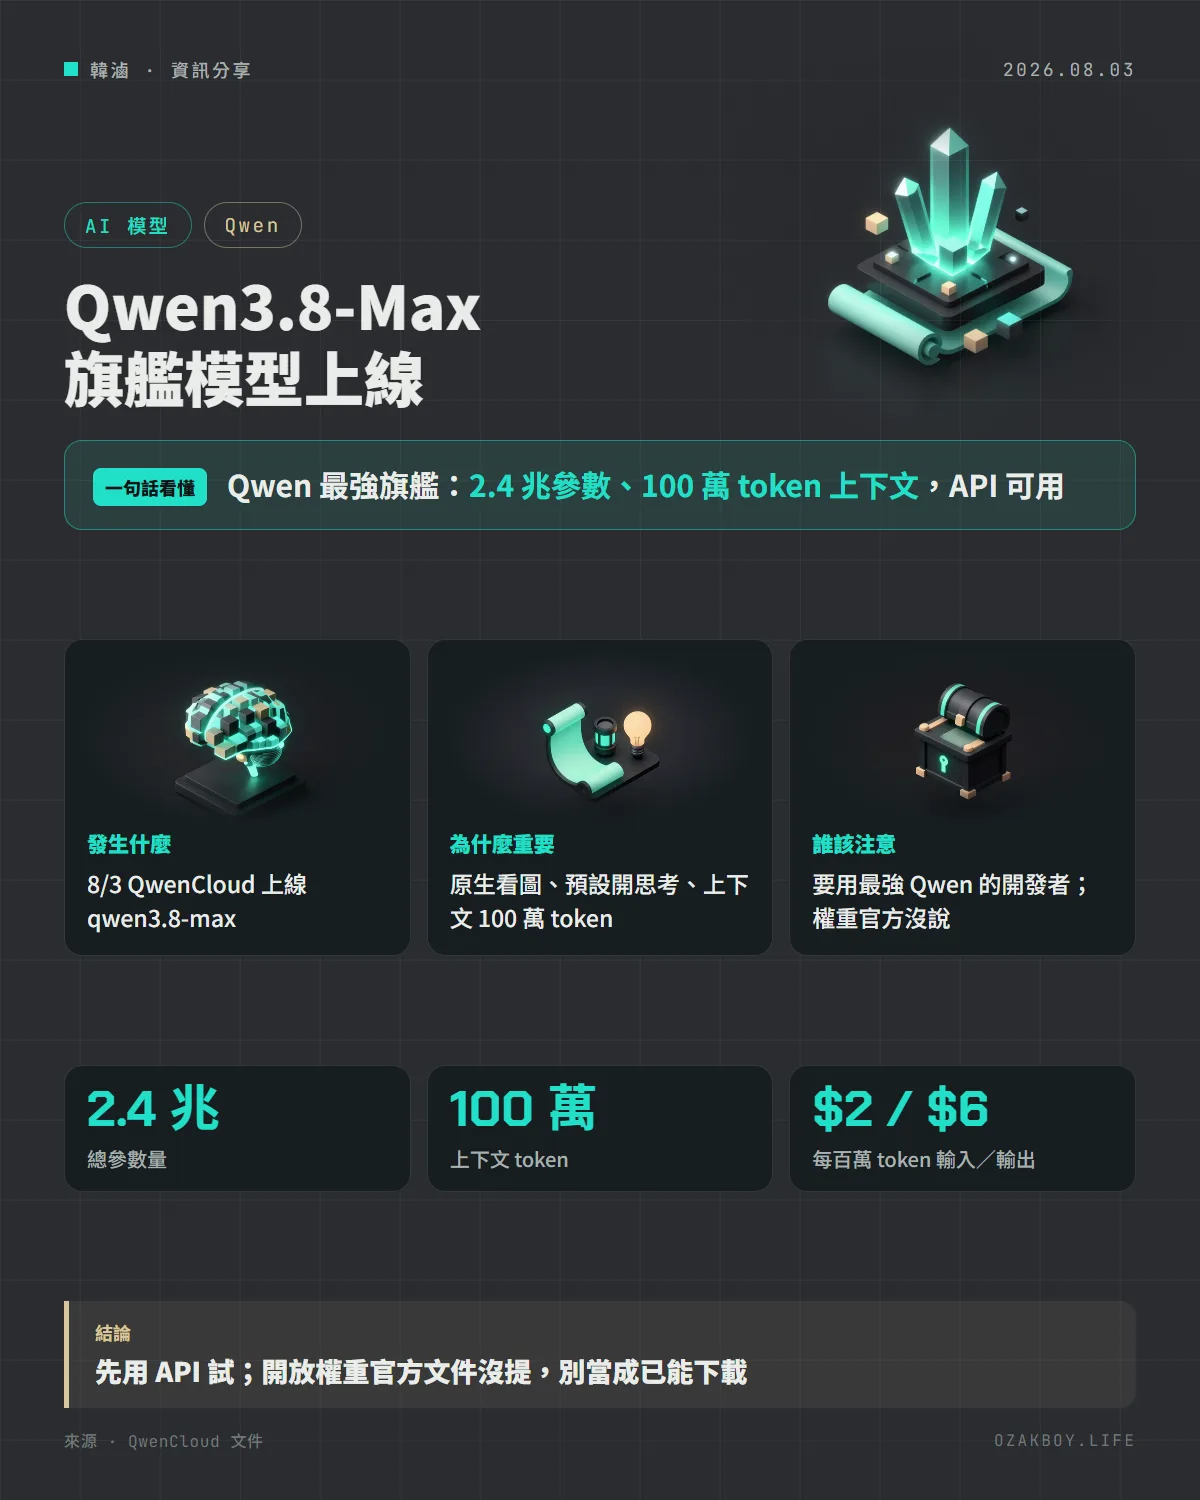
阿里巴巴的 Qwen 團隊在 8 月 3 日把旗艦模型 Qwen3.8-Max 放上 QwenCloud:混合專家架構、總參數 2.4 兆、原生看圖、預設開啟思考模式、上下文 100 萬 token。官方文件目前沒有提到開放權重。
- 發布
- 2026-08-03
- 篇幅
- 約 4 分鐘 · 1,597 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:Qwen 團隊在 8 月 3 日把旗艦模型 Qwen3.8-Max 放上 QwenCloud:總參數 2.4 兆的混合專家模型,原生看圖、預設開思考、上下文 100 萬 token。
先用白話講:「2.4 兆參數」和「混合專家」是什麼?
參數可以想成 AI 的「腦細胞」數量,數字越大,模型能記住與組合的東西越多,但也越吃硬體。
混合專家(Mixture of Experts,MoE)則像一家大公司:裡面有很多不同專長的小組,每次收到問題,只叫最適合的幾組出來處理,不是全公司一起上。所以雖然「總共」有 2.4 兆參數,一次回答並不會把它們全部動用。
發生什麼事
QwenCloud(Qwen 的雲端 API 平台)的模型更新日誌,在 8 月 3 日加上了一筆 qwen3.8-max,官方描述:
- 目前 Qwen 最強的旗艦模型
- 原生的視覺語言模型(能看圖也能讀文字)
- 混合專家架構,總參數 2.4 兆
- 效能「可比擬目前最先進的模型」,比 3.7 系列有明顯進步(這是官方自己的說法)
- 支援混合思考模式(預設開啟),上下文視窗 100 萬 token
「上下文視窗 100 萬 token」大概是什麼概念?token 是 AI 計算文字量的單位,一個中文字大約是一個 token 上下。100 萬 token,約等於一百萬個中文字,相當於好幾本書的篇幅(自行粗略換算,並非官方說法)。
價格與取得方式
| 項目 | 內容 |
|---|---|
| 價格 | QwenCloud 現行頁面標示:每百萬 token 輸入 2 美元、輸出 6 美元(現況頁面,可能調整) |
| 怎麼用 | 在 QwenCloud 建立 API 金鑰,用 OpenAI 相容介面呼叫 |
| 模型名稱 | qwen3.8-max |
| 開放權重 | 官方這則更新沒有提到 |
給開發者的技術細節
官方文件的第一次呼叫範例,是用 OpenAI 的 Python 套件,只要換掉網址與金鑰:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),  # 金鑰放環境變數,不要寫進程式碼
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[{"role": "user", "content": "你好"}],
)
print(completion.choices[0].message.content)
- 金鑰依區域分開:範例用的是新加坡(ap-southeast-1)的網址,要用別的區域,網址與金鑰都要換成該區域的
- 官方文件說,新使用者在新加坡區域有免費額度可以試用
- 思考模式預設開啟,代表回覆可能比較慢、也會多花輸出 token;不需要時要看文件怎麼關閉
- 這裡的程式碼與網址取自官方現況文件,實際請以你登入後看到的為準
我的看法
2.4 兆這個數字很驚人,但以我的使用情境(小團隊接案、在 NAS 上跑小型模型)來看,它的意義不在「我能不能自己跑」,而是「Qwen 把旗艦模型放到雲端,開放平台可以直接串」。如果你的客戶需要中文表現不錯、又要看圖與長文件的功能,這是一個可以拿去跟其他家比較的選項。
至於「開放權重」,這則官方更新完全沒提,我不會把它當成已經能下載的開源模型。Qwen 過去有不少模型是開放權重的,但每一款各自不同,要看官方實際釋出的頁面。目前能做的,就是用 API 拿自己的真實資料測一測,不要只看排行榜。
名詞小辭典
- 混合專家(MoE):把模型分成很多專家小組,每次只讓一部分出力的設計。
- 上下文視窗(Context window):模型一次能「看」的文字量上限。
- 開放權重(Open weights):公開訓練好的模型參數,讓人下載使用與微調。
- OpenAI 相容介面:用跟 OpenAI 一樣的呼叫方式,換個網址就能接上別家的模型。