觀點 · 資訊分享
Qwen 開放 Flash-Next 權重:1,250 億參數每次只動 60 億,Qwen4 新架構先試跑
Qwen 在 8 月 24 日把 Qwen3.8-Flash-Next 的權重放上 Hugging Face,官方稱它是 Qwen4 架構的預覽版。總參數 125B、每次啟動 6B,原生支援 262,144 token 上下文。
- 發布
- 2026-08-24
- 篇幅
- 約 5 分鐘 · 2,045 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
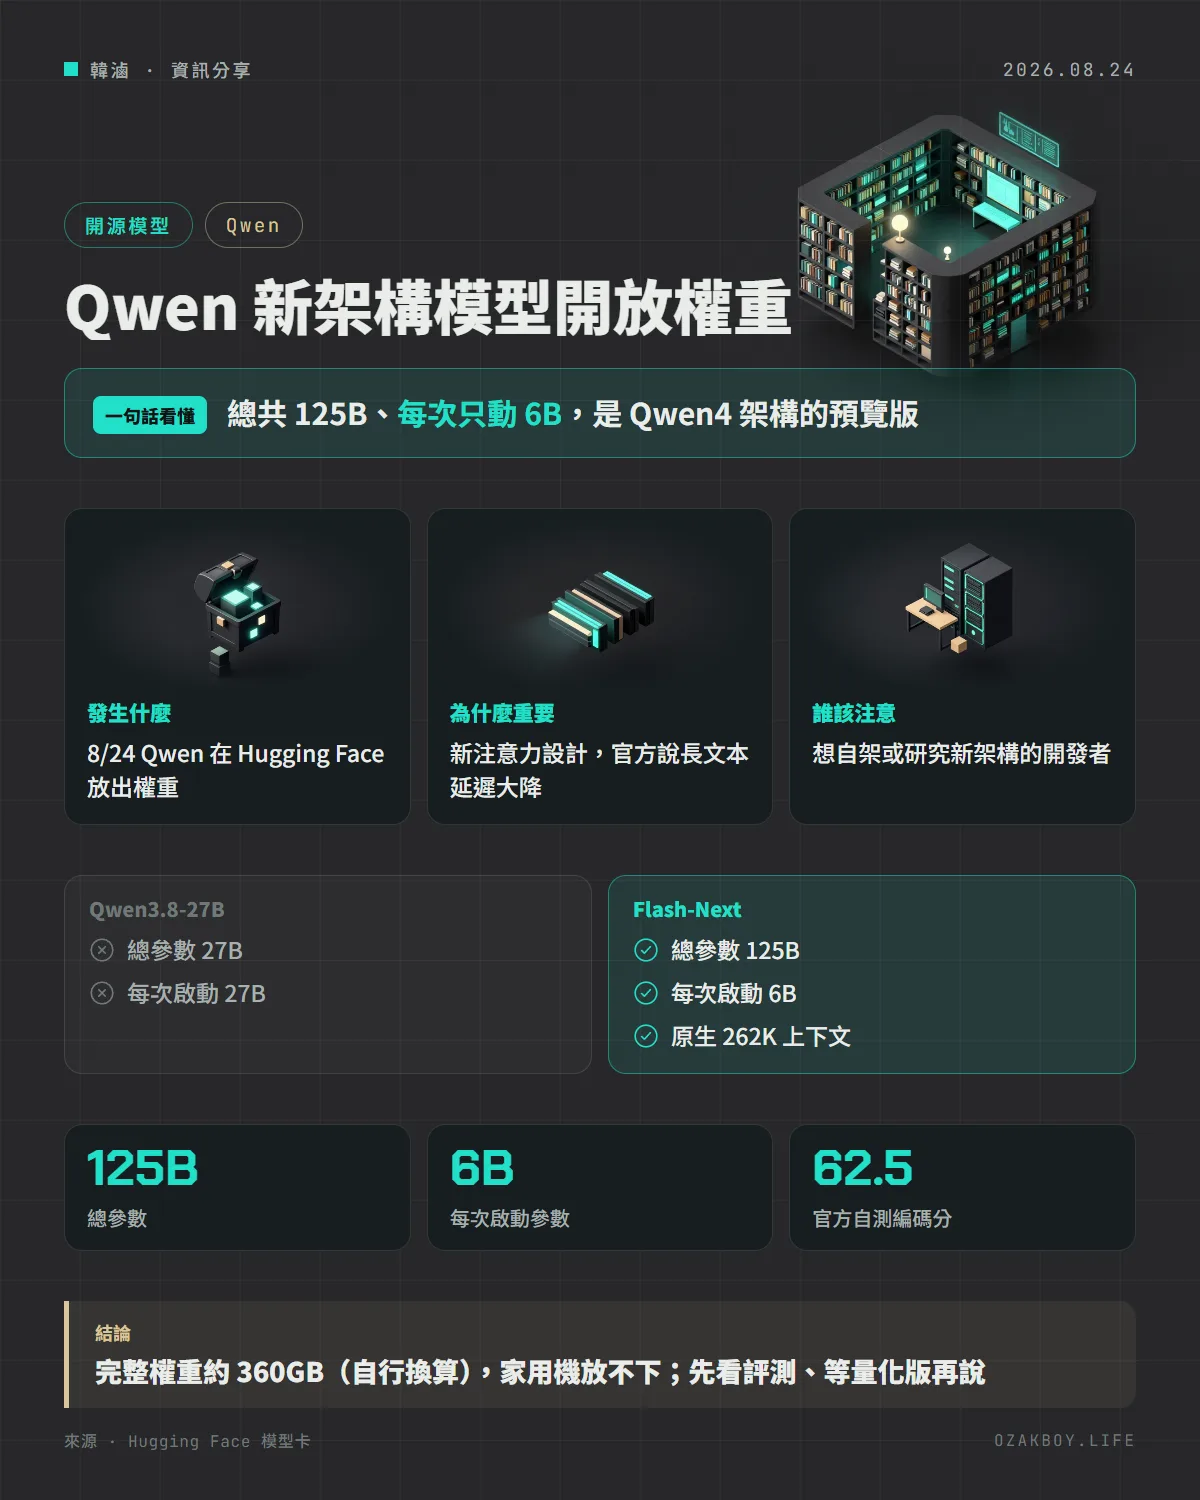
一句話看懂:Qwen 團隊在 8 月 24 日把 Qwen3.8-Flash-Next 的權重放上 Hugging Face:總共 1,250 億參數,但每次只動用 60 億,是他們為下一代 Qwen4 先試跑的新架構。
先用白話講:「1,250 億參數、只用 60 億」是什麼意思?
想像一間大醫院有幾百位專科醫師。你掛號看感冒,不會把全院醫師都叫來,只會請內科、耳鼻喉科的幾位出診。
這類模型叫 MoE(專家混合):模型裡有很多位「專家」,每次回答只挑最相關的幾位出力。所以它的「知識量」很大(總參數 125B),但每次實際計算的量很小(啟動參數 6B),回答速度和成本比同等級的「全員出動」型模型友善。
發生什麼事
Qwen 團隊在 8 月 24 日於 Hugging Face 公開 Qwen3.8-Flash-Next(也同時放出 FP8 壓縮版)。官方把它定位成「Qwen4 架構的實驗性預覽」,也就是說,這不是新一代旗艦,而是拿新設計先給大家試用。
官方模型卡列出的新設計有四項:
- Qwen Sparse Attention(QSA):處理長文章時,不是逐字比對,而是以「小區塊」為單位挑重點看,官方說能大幅降低長文本的延遲
- Gated Residual:改良模型內部層與層之間傳遞資訊的方式
- N-gram Embedding:用短詞組來擴充參數,官方說對記憶體吃緊的硬體比較有效率
- 新的訓練配方:訓練時省掉逐步提高批次大小的暖身階段
模型本身也能看圖片與影片。
規格一眼看
| 面向 | Qwen3.8-Flash-Next |
|---|---|
| 總參數 | 125B,另有 51B 的 n-gram 嵌入與 4B 的多 token 預測模組 |
| 每次啟動 | 6B |
| 專家數 | 512 個,每次啟用 10 個加 1 個共用 |
| 上下文長度 | 原生 262,144 token,可延伸到 100 萬 |
| 授權 | qwen-community-1.0(不是 Apache 2.0) |
跑分怎麼樣?
以下是官方模型卡上的自家測試成績(Qwen 自己跑的,不是第三方):
| 測驗 | Flash-Next | Qwen3.8-27B | DeepSeek-V4-Flash-0731 | Claude Opus 4.6(最高檔) |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 未提供 | 77.5 |
| GPQA Diamond | 91.7 | 89.2 | 90.8 | 91.3 |
| HLE | 35.9 | 30.8 | 33.8 | 40.0 |
有贏有輸:寫程式類跑得好,但在 HLE 這種高難度綜合題上,Opus 4.6 的 40.0 還是比較高。另外 Opus 的 SWE-bench Pro 分數用的是官方公布值,其他模型是 Qwen 自己重跑的,比較時要留意。
給開發者的技術細節
- 權重相容 Hugging Face Transformers、vLLM、SGLang、TokenSpeed;官方建議正式服務用 SGLang、KTransformers 或 vLLM
- 預設會先思考再回答,可用
enable_thinking關掉;思考強度reasoning_effort有 xhigh(預設)、medium、low 三檔 - 要超過 262,144 token,要開 YaRN 並把
factor設成 4.0 左右;但官方提醒目前框架都是「靜態 YaRN」,短文本表現可能會被拉低,所以真的需要長上下文再開
# 關掉思考、直接要答案(官方範例的寫法,連到本機 vLLM 時)
client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
    temperature=0.7,
    top_p=0.8,
    extra_body={"top_k": 20, "chat_template_kwargs": {"enable_thinking": False}},
)
後續:8 月 26 日,Ollama 的 v0.33.1 版更新日誌寫到「MLX:支援 Qwen3.8 Flash Next」,也就是 Apple 晶片的 Mac 上可以用 Ollama 的 MLX 引擎跑這個模型。
我的看法
先講最現實的:BF16 權重共約 1,800 億個參數,每個參數 2 byte,光權重就約 360 GB(自行換算)。這不是家用 NAS 或一般筆電能跑的東西,自架得靠大記憶體的 Mac 或多張顯卡,或是等社群出量化版。
對接案的我來說,這個模型的價值在兩個地方:一,它證明「大而稀疏」的路線能把成本壓低,之後的 Qwen4 很可能延續;二,授權是 Qwen 自己的社群授權,我沒有讀授權全文,商用之前要先看過 LICENSE,別因為它放在 Hugging Face 就當成可以隨便用。
如果只是想試試,官方建議的路線其實是用雲端 API,而不是自己架。
名詞小辭典
- 開放權重(Open Weights):模型訓練好的數值檔案公開下載,可以自己跑,但不一定連訓練資料與程式都開放。
- MoE(專家混合):模型由很多專家組成,每次只啟動其中一部分來回答。
- 上下文長度(Context Length):模型一次能讀進去的內容量,單位是 token。
- YaRN:一種讓模型處理超過原本訓練長度文章的技巧。