觀點 · 資訊分享
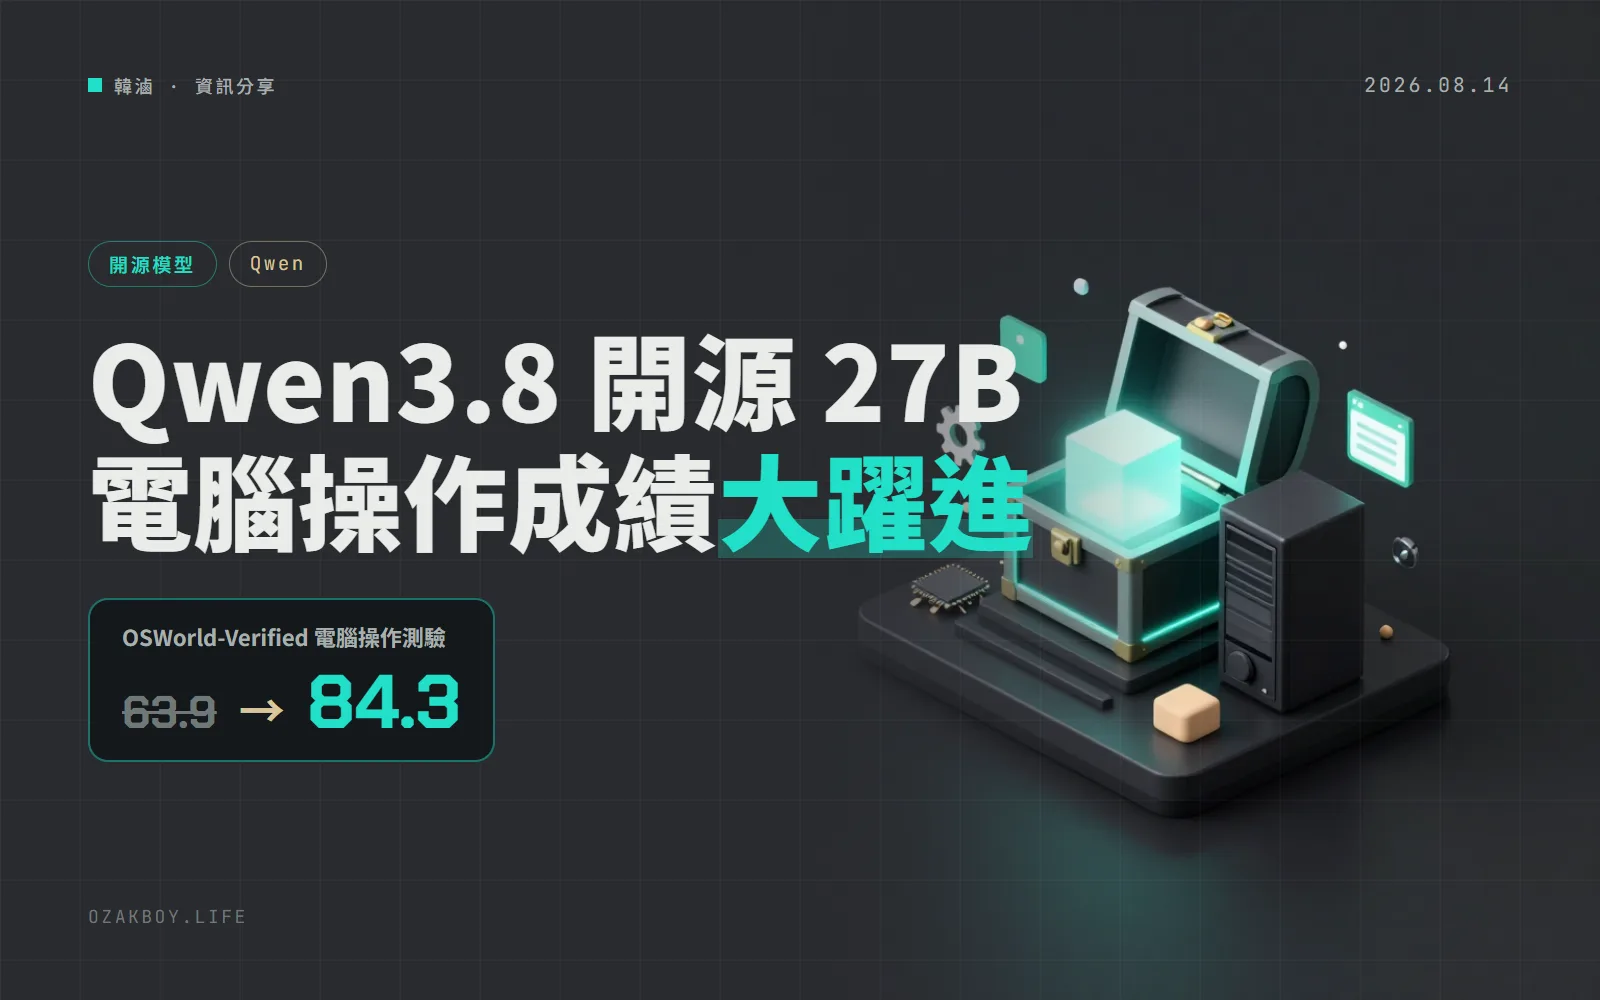
Qwen3.8-27B 開放權重:電腦操作測驗從 63.9 跳到 84.3,Apache 2.0 授權、能自己架
阿里的 Qwen3.8-27B 把模型權重放上 Hugging Face,能看圖、看影片,上下文 262K。官方測驗中,電腦操作、寫程式都比上一代 27B 大幅進步,而且是 Apache 2.0 授權。
- 發布
- 2026-08-14
- 篇幅
- 約 4 分鐘 · 1,661 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
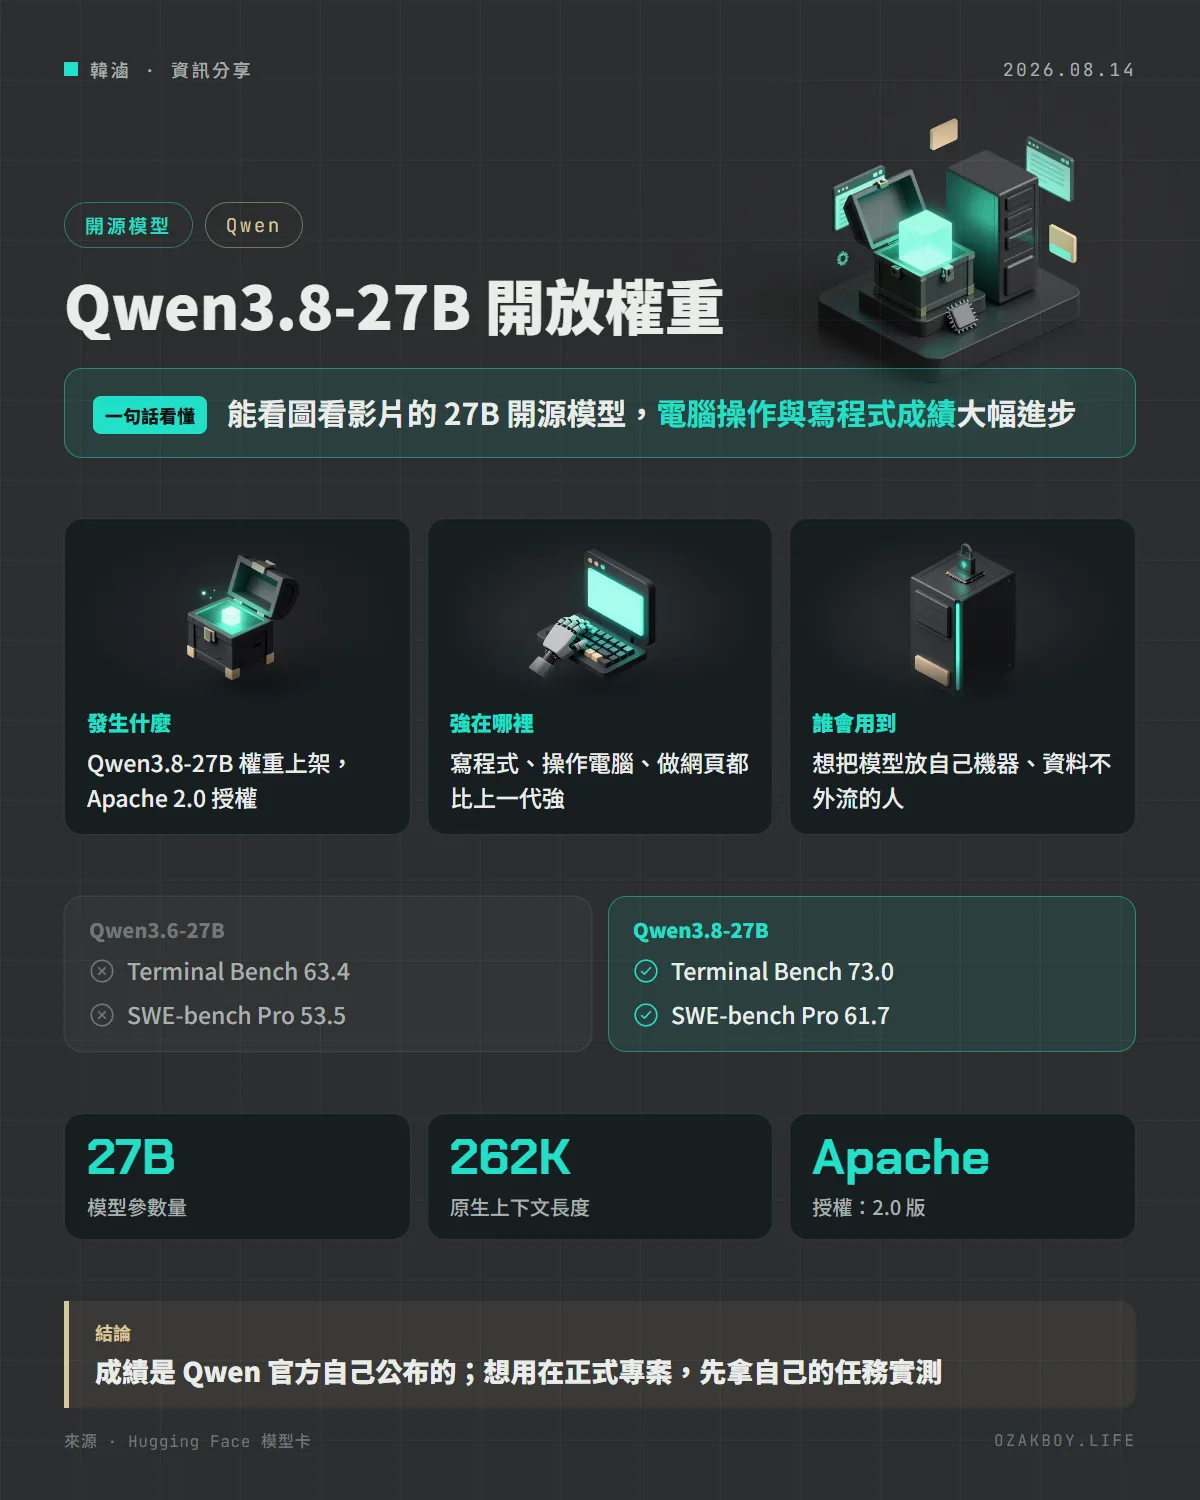
一句話看懂:Qwen 把 27B 的新模型 Qwen3.8-27B 放上 Hugging Face,能看圖、看影片,電腦操作與寫程式的官方成績比上一代進步很多,而且是 Apache 2.0 授權,可以自己下載來用。
先用白話講:「開放權重」是什麼?
AI 模型就像一位已經學成的員工。雲端 AI 是「你打電話請他幫忙」,資料要傳出去;開放權重則是「把這位員工的腦袋複製一份給你」,你可以放在自己的電腦或伺服器上跑,資料不用離開家裡。
Qwen 是阿里巴巴的模型系列,這次發布的 Qwen3.8-27B,就是這種可以下載回家的版本。
發生什麼事
Qwen 在 Hugging Face 公開了 Qwen3.8-27B 的模型卡與權重。官方稱它是 Qwen 開放模型家族中「目前最強的一代」,重點放在寫程式、專業工作、研究與長時間的代理任務。
這個模型的規格:
- 270 億參數的稠密(dense)模型,並內建視覺編碼器,能看懂圖片與影片
- 原生上下文 262,144 token,可延伸到 1,000,000 token
- 思考模式預設開啟,可用
reasoning_effort調成xhigh(預設)、medium、low - 授權為 Apache 2.0
跟上一代比,進步多少?
下表是模型卡上 Qwen 自己公布的成績(越高越好):
| 測驗 | Qwen3.6-27B | Qwen3.8-27B |
|---|---|---|
| Terminal Bench 2.1(在終端機完成任務) | 63.4 | 73.0 |
| SWE-bench Pro(修真實專案的問題) | 53.5 | 61.7 |
| DeepSWE 1.1(修真實專案的問題) | 13.3 | 42.2 |
| OSWorld-Verified(操作電腦) | 63.9 | 84.3 |
| WebArena-Verified(操作瀏覽器) | 48.8 | 64.8 |
模型卡也放了 Opus 4.6 Max 做比較:Terminal Bench 2.1 是 Opus 的 78.2 較高,SWE-bench Pro 與 OSWorld-Verified 則是 Qwen 較高。所以不是全面領先,而是在特定任務上很強。
給開發者的技術細節
- 權重與 Transformers 相容,官方建議正式環境用 SGLang、vLLM 或 TokenSpeed 部署
- 官方託管版(Qwen Cloud)標示為「即將推出」,預設會支援 1M 上下文與內建工具
- 官方提醒:在多輪的代理任務裡,把推理強度調低,不一定比較快,可能因為分析不足而重試更多次,總耗時反而更長
- 社群已在 8 月 13 日放出 GGUF 量化版(Unsloth),適合想用本機工具執行的人,但記憶體需求要依選的量化等級自己評估
# 改寫自官方範例:用 OpenAI 相容介面呼叫,指定推理強度
completion = client.chat.completions.create(
    model="Qwen/Qwen3.8-27B",
    messages=messages,
    reasoning_effort="medium",
)
我的看法
我自己在家用 NAS 與本地 AI 跑一些自動化,最在意的是「資料不外流」與「成本固定」。27B 這個大小,對個人或小團隊算是還有機會自己架的等級,加上 Apache 2.0 授權,要放進客戶專案也比較沒有授權上的顧慮。
不過要提醒兩件事:第一,這些成績都是官方自己公布的,不同測驗的設定也不一樣,別直接當成保證;第二,「能跑」和「跑得順」是兩回事,262K 上下文很吃記憶體,實際用之前先量測自己的機器。我的做法是先拿手邊的真實任務(例如改一段舊程式、整理一份文件)跑一輪,再決定要不要換掉現在的模型。
名詞小辭典
- 開放權重(Open Weights):把訓練好的模型檔案公開,任何人都能下載後自己執行。
- 稠密模型(Dense):每次處理都動用全部參數,和只啟用部分專家的 MoE 模型不同。
- 上下文長度(Context):模型一次能「讀進去」的內容量,用 token 計算。
- 量化(Quantization):把模型壓縮成較小的檔案,換取更低的記憶體需求,但品質可能略降。