觀點 · 資訊分享
ComfyUI 0.31.0 釋出:支援 Wan-Animate2、修好 MiniMax H3 多個問題,LTX 小幅加速約 2.5%
ComfyUI 在 8 月 8 日(UTC)釋出 0.31.0:新增 Wan-Animate2 支援、修正 MiniMax H3 的多個問題,LTX 與 Wan 的優化在 RTX 5090 上約快 2.5%。
- 發布
- 2026-08-08
- 篇幅
- 約 4 分鐘 · 1,711 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
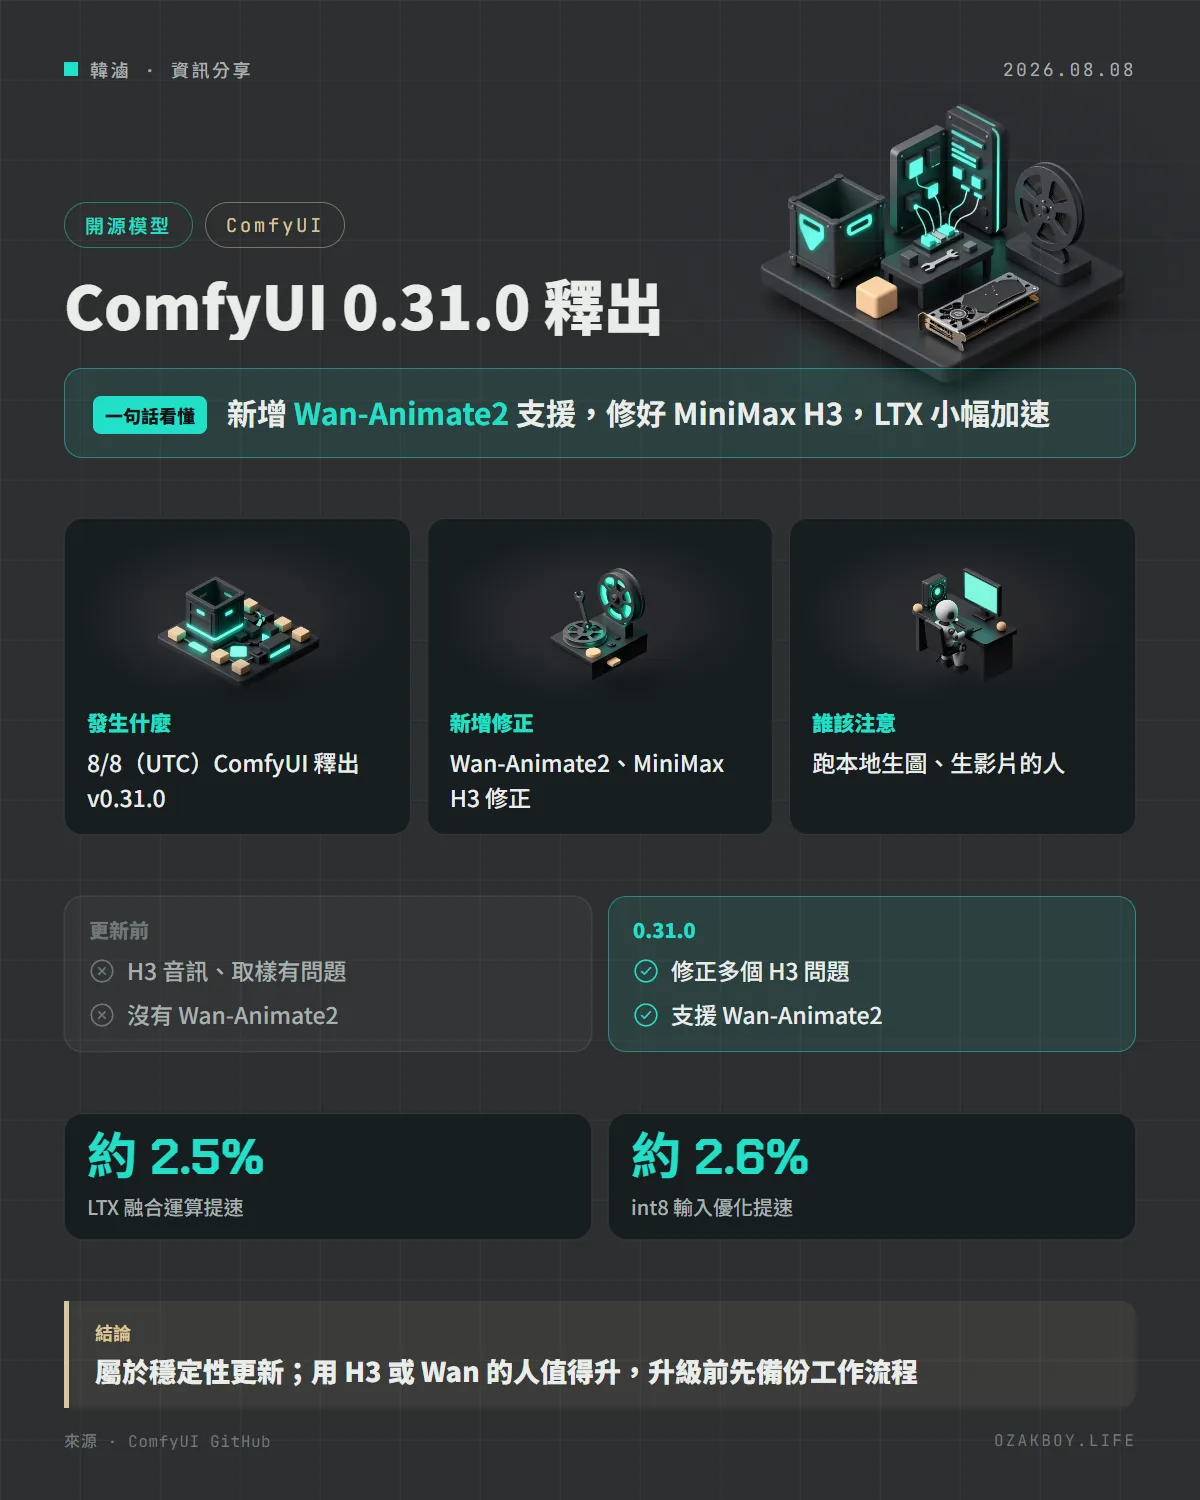
一句話看懂:ComfyUI 0.31.0 發布,新增 Wan-Animate2 支援、修好 MiniMax H3 影片模型的多個問題,LTX 與 Wan 小幅加速,同時開始支援幾個雲端夥伴的新模型。
先用白話講:ComfyUI 是什麼?
想像做 AI 圖片或影片,就像在廚房做菜:「讀取模型」是拿食材、「採樣」是下鍋煮、「解碼」是擺盤。ComfyUI 把每個步驟做成一塊積木,你用線把積木接起來,就組成自己的料理流程。因為每個步驟都看得見,想換食材或改火候都很方便,所以很多人拿它在自己的電腦上跑生圖與生影片。
ComfyUI 本身也經常更新,每次新版本主要是在「支援更多食譜(新模型)」與「讓廚房跑得更順」。
發生什麼事
ComfyUI 在 8 月 8 日(UTC)釋出 v0.31.0。依官方發布說明,這一版比較值得注意的有:
- 新模型支援:加入 Wan-Animate2 的支援
- MiniMax H3 影片模型:修了多個問題,涵蓋 H3 的 VAE、噪聲遮罩取樣、音訊取樣與 EasyCache 造成的音訊損壞,並新增 int8 版 VAE 的支援
- LTX 與 Wan 加速:用融合運算與 int8 的小改動換來速度提升
- 記憶體:在沒有 swap(交換空間)的 Linux 系統上,不再釘住過多記憶體
- 安全加固:對一些節點做了防範「下拉選單(combo)相關問題」的強化
- 夥伴節點(Partner Nodes,串接雲端服務的節點):新增 BFL 的 Flux 3 影片模型、字節跳動的 SeeDance 2.5、Topaz 的 Bloom 2 與 Wonder 3.5;同時移除已停用的 Kling 舊模型與虛擬試穿 API,並棄用 Reve 節點
「加速」到底有多快?
要看其中一個 PR 的說明才知道,數字很誠實:
| 優化項目 | 測到的速度提升 | 測試環境 |
|---|---|---|
| LTX 的 rms_adaln 融合 | 約 2.5% | RTX 5090 |
| LTX、Wan 的 int8 輸入優化 | 約 2.6%(用 int8 權重時) | RTX 5090,峰值顯存也略降 |
也就是說,這是「小幅」進步,不是翻倍。對天天跑長影片的人,積少成多還是有感。
給開發者與自架玩家的細節
- 如果你用的是沒有 swap 的 Linux,這版的調整是「不要釘住過多記憶體」,細節請看對應的提交說明
- 夥伴節點是串接外部雲端服務的節點,費用與規則依各家而定,這次的發布說明沒有提到;本地模型不受影響
- 後續(8 月 11 日):v0.32.0 釋出,官方最低支援的 PyTorch 提高到 2.7,並加入 LTX 2.5 支援。如果你的環境還是舊版 PyTorch,升級前先確認
我的看法
自己架本地 AI 的人,最怕的就是「更新之後某個模型壞掉」。ComfyUI 的好處是每次發布說明都列得很細,所以我習慣先看一遍再決定升不升。
這次的重點不是華麗新功能,而是一堆修補與小加速,屬於「穩定性更新」。我的建議是:如果你正在用 MiniMax H3 或 Wan 系列,值得升級;如果你的流程已經穩定、而且沒有新需求,可以等一兩個版本看看社群有沒有回報問題再動。升級前記得備份自己的工作流程與自訂節點資料夾。
名詞小辭典
- 工作流程(Workflow):ComfyUI 裡一整串接好的積木,等於一份可重複使用的食譜。
- VAE:負責把圖片或影片在「壓縮後的資料」和「真正畫面」之間轉換的元件。
- int8:一種把模型數字壓得更小的方式,用精度換速度與記憶體。
- Swap(交換空間):記憶體不夠用時,作業系統暫時借用硬碟當記憶體的空間。
資料來源
常見問題
ComfyUI 是什麼?
一個用「節點連線」方式組合 AI 生圖、生影片流程的開源工具,可以在自己的電腦上執行,每個步驟都看得見,方便替換模型或調整設定。
0.31.0 的加速有多明顯?
依相關 PR 的說明,LTX 的融合運算在 RTX 5090 上約快 2.5%,LTX 與 Wan 的 int8 輸入優化在使用 int8 權重時約快 2.6%,顯存峰值也略降。算是小幅進步,不是倍數級。
升級前要注意什麼?
建議先備份自己的工作流程與自訂節點。後續的 v0.32.0(8 月 11 日)把官方最低支援的 PyTorch 提高到 2.7,若你的環境還是舊版,要先確認相容性。
接著讀
全部觀點 →KoboldCpp 1.119 加入 MiniMax H3 影片生成:本機跑 AI 的單檔工具,也完整支援 Qwen3.8本機跑語言模型的單檔工具 KoboldCpp 釋出 1.119,新增 MiniMax H3 的文字生影片與圖生影片,也完整支援 Qwen3.8 與 Meta 的 Muse Glimmer,圖片 LoRA 上限從 4 個提高到 10 個。閱讀 →Ollama 加入 d3 決策模型:本機就能做分類、是非題與評分,最小 2B 版約 3.6GB 記憶體Ollama 0.40.11 在 10 月 24 日帶進 vLLM Semantic Router 的 d3 決策模型。它不聊天,只回答「分到哪一類、是或不是、幾分」,有 2B 到 27B 四種大小,Apache 2.0 授權,可以在自己的電腦上跑。閱讀 →Flint 開源程式模型上架 Ollama:約 400 億參數、每次只動 25 億,Apache 2.0 授權Recursive 的開源程式模型 Flint 在 10 月 21 日登上 Ollama,一行指令就能在自己電腦跑。它是混合專家架構,總共約 400 億參數,處理每個 token 只動用約 25 億,下載大小 23GB。閱讀 →