觀點 · 資訊分享
KoboldCpp 1.119 加入 MiniMax H3 影片生成:本機跑 AI 的單檔工具,也完整支援 Qwen3.8
本機跑語言模型的單檔工具 KoboldCpp 釋出 1.119,新增 MiniMax H3 的文字生影片與圖生影片,也完整支援 Qwen3.8 與 Meta 的 Muse Glimmer,圖片 LoRA 上限從 4 個提高到 10 個。
- 發布
- 2026-08-16
- 篇幅
- 約 4 分鐘 · 1,683 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
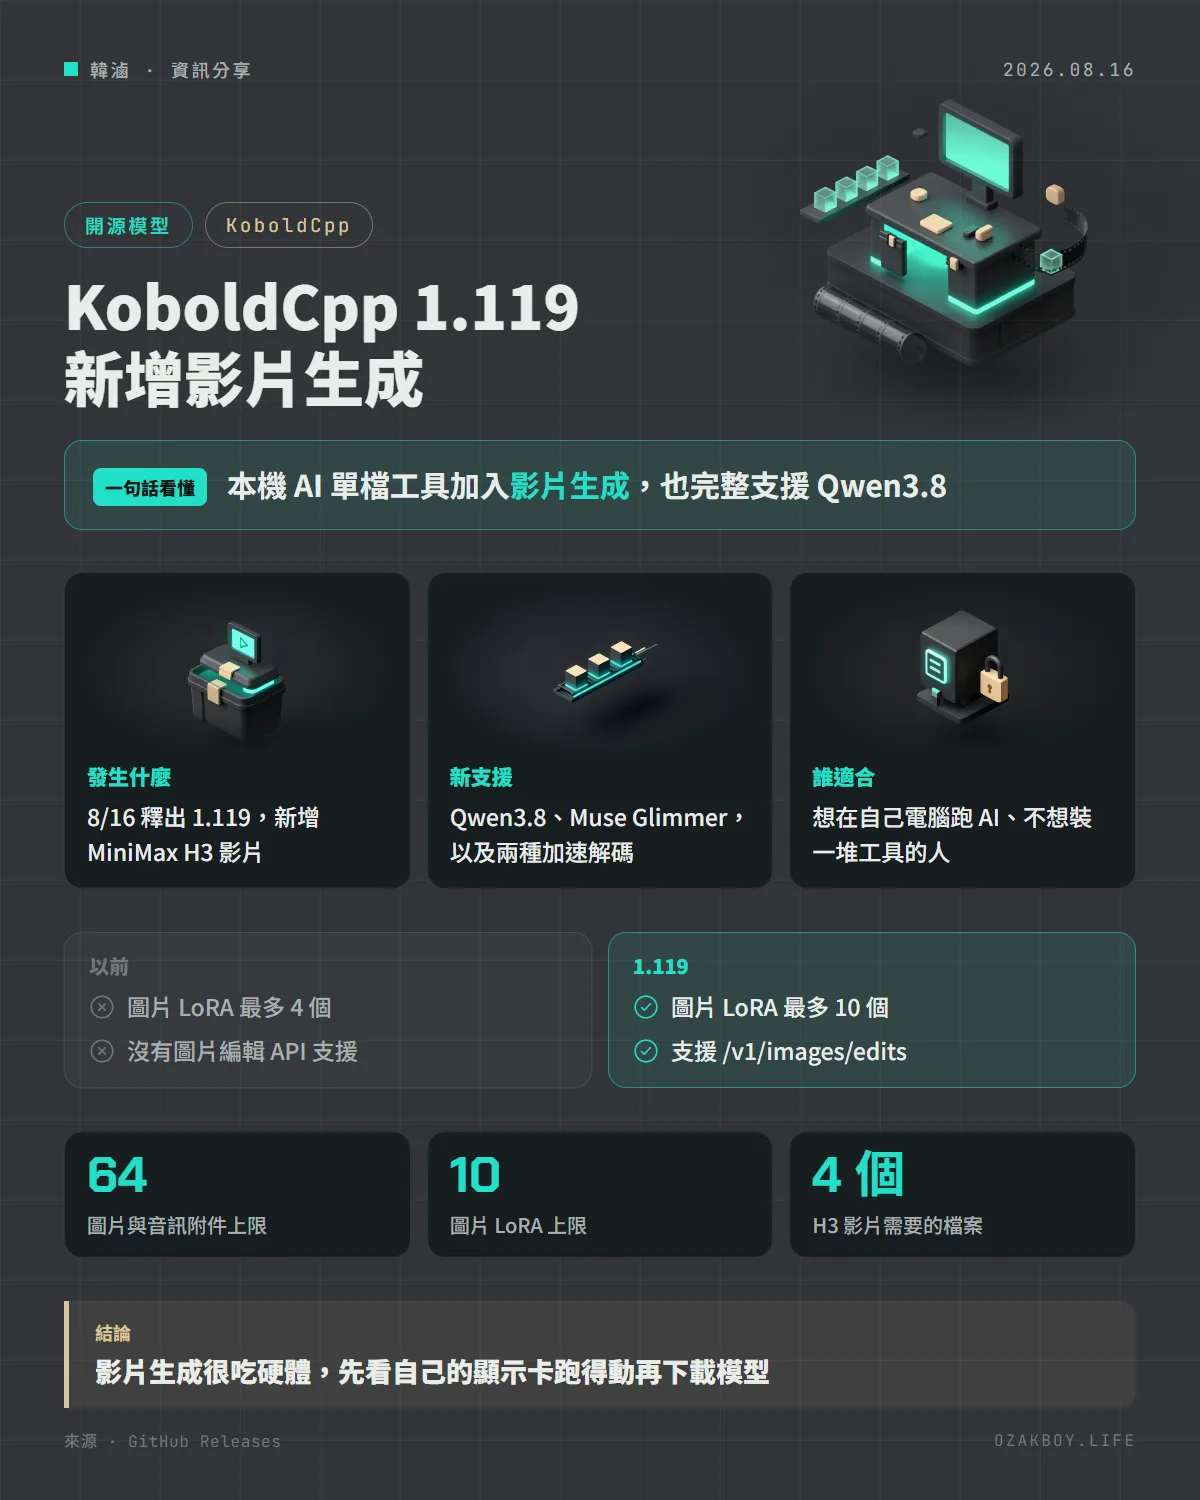
一句話看懂:本機跑 AI 的單檔工具 KoboldCpp 釋出 1.119,新增 MiniMax H3 的影片生成,也完整支援 Qwen3.8 與 Meta 的 Muse Glimmer,在自己電腦上能做的事又多了一些。
先用白話講:KoboldCpp 是什麼?
雲端 AI 像是「叫外送」,方便但資料要交給別人。在自己電腦跑 AI 像是「自己下廚」,隱私與成本都自己掌握,但需要工具。
KoboldCpp 就是這類工具中很省事的一個:Windows 與 Linux 版都是單一執行檔,下載後直接執行,再用瀏覽器開 http://localhost:5001,就能開始跟本機模型互動。官方也提供不同版本:NVIDIA 顯示卡用的標準版、較舊電腦用的 oldpc 版、沒有 NVIDIA 顯示卡的 nocuda 版(AMD 建議先試其中的 Vulkan 選項),以及 M 系列 Mac 的版本。
發生什麼事
KoboldCpp 在 8 月 16 日釋出 1.119,重點如下:
- 新增影片生成:支援 MiniMax H3 的文字生影片與圖生影片(I2V)
- 新增 Muse Glimmer 支援:Meta 的模型,支援 jinja 範本與工具呼叫;Qwen 3.8 也已完整支援
- 新增 DSpark 與 DFlash 兩種推測式解碼的支援
- 圖片與音訊附件的上限提高到 64
- 執行期可同時載入的圖片 LoRA 從 4 個提高到 10 個
- 圖片生成新增進度顯示與預覽,並支援 OpenAI 的圖片編輯 API
/v1/images/edits - 修正圖片生成的記憶體洩漏
MiniMax H3 影片怎麼用?
官方說明需要 4 個檔案,詳細說明在 stable-diffusion.cpp 的 MiniMax-H3 文件,並提供 .kcppt 設定範本讓你少填一些參數。
從該文件可以知道,MiniMax-H3 是會同時生成影片與立體聲音訊的模型;它的文字編碼器是 Qwen3-VL-32B 的特殊版本,所以檔案不小。KoboldCpp 這次的更新說明提到的是「影片生成與圖生影片」,音訊部分官方沒有特別說明。
給開發者的技術細節
- 啟動後預設在
http://localhost:5001,也可以用--help查看所有啟動參數 - 圖片相關的 OpenAI 相容端點新增了
/v1/images/edits,原有的圖片端點也支援 Autoswap(自動切換模型) - 官方提醒:另有每日自動更新的 rolling 實驗版,可能不穩定,正式使用建議用正式版
- 模型檔大小與硬體需求,官方更新說明沒有列出,請以各模型自己的說明為準
我的看法
我很喜歡這種「一個檔案就能跑」的工具,因為自己在 NAS 與家用電腦上試各種本地 AI,最怕的是環境設定一堆、換個版本就壞。KoboldCpp 這種單檔設計,特別適合想先試試看、又不想弄壞現有環境的人。
不過影片生成要有心理準備:H3 光是 4 個檔案就不小,文字編碼器本身就是 32B 等級的模型,對一般顯示卡負擔很重。我的建議是先在自己熟悉的語言模型上試,確認工具好用,再來評估要不要為影片生成升級硬體。客戶專案要用的話,也要先確認模型的授權條款允許商用。
名詞小辭典
- LoRA:一種小型的「風格外掛檔」,掛在圖片模型上,就能改變畫風或加入特定角色。
- 推測式解碼(Speculative Decoding):先快速猜幾個字、再讓大模型一次驗證,用來加速回答的技巧。
- 圖生影片(I2V):給一張圖片,讓 AI 生成一段從這張圖出發的影片。
- jinja 範本:決定對話內容怎麼排版後送給模型的格式檔,不同模型要用對應的範本。