觀點 · 資訊分享
Meta 開放 Muse Glimmer 30B 權重:Apache 2.0 授權、為本機 AI 代理設計,一張消費級顯卡放得下
Meta 在 8 月 10 日開放 Muse Glimmer 的權重:30B 參數、Apache 2.0 授權,能看圖片、呼叫工具,官方說壓縮後語言模型小於 20 GB。
- 發布
- 2026-08-10
- 篇幅
- 約 5 分鐘 · 2,132 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
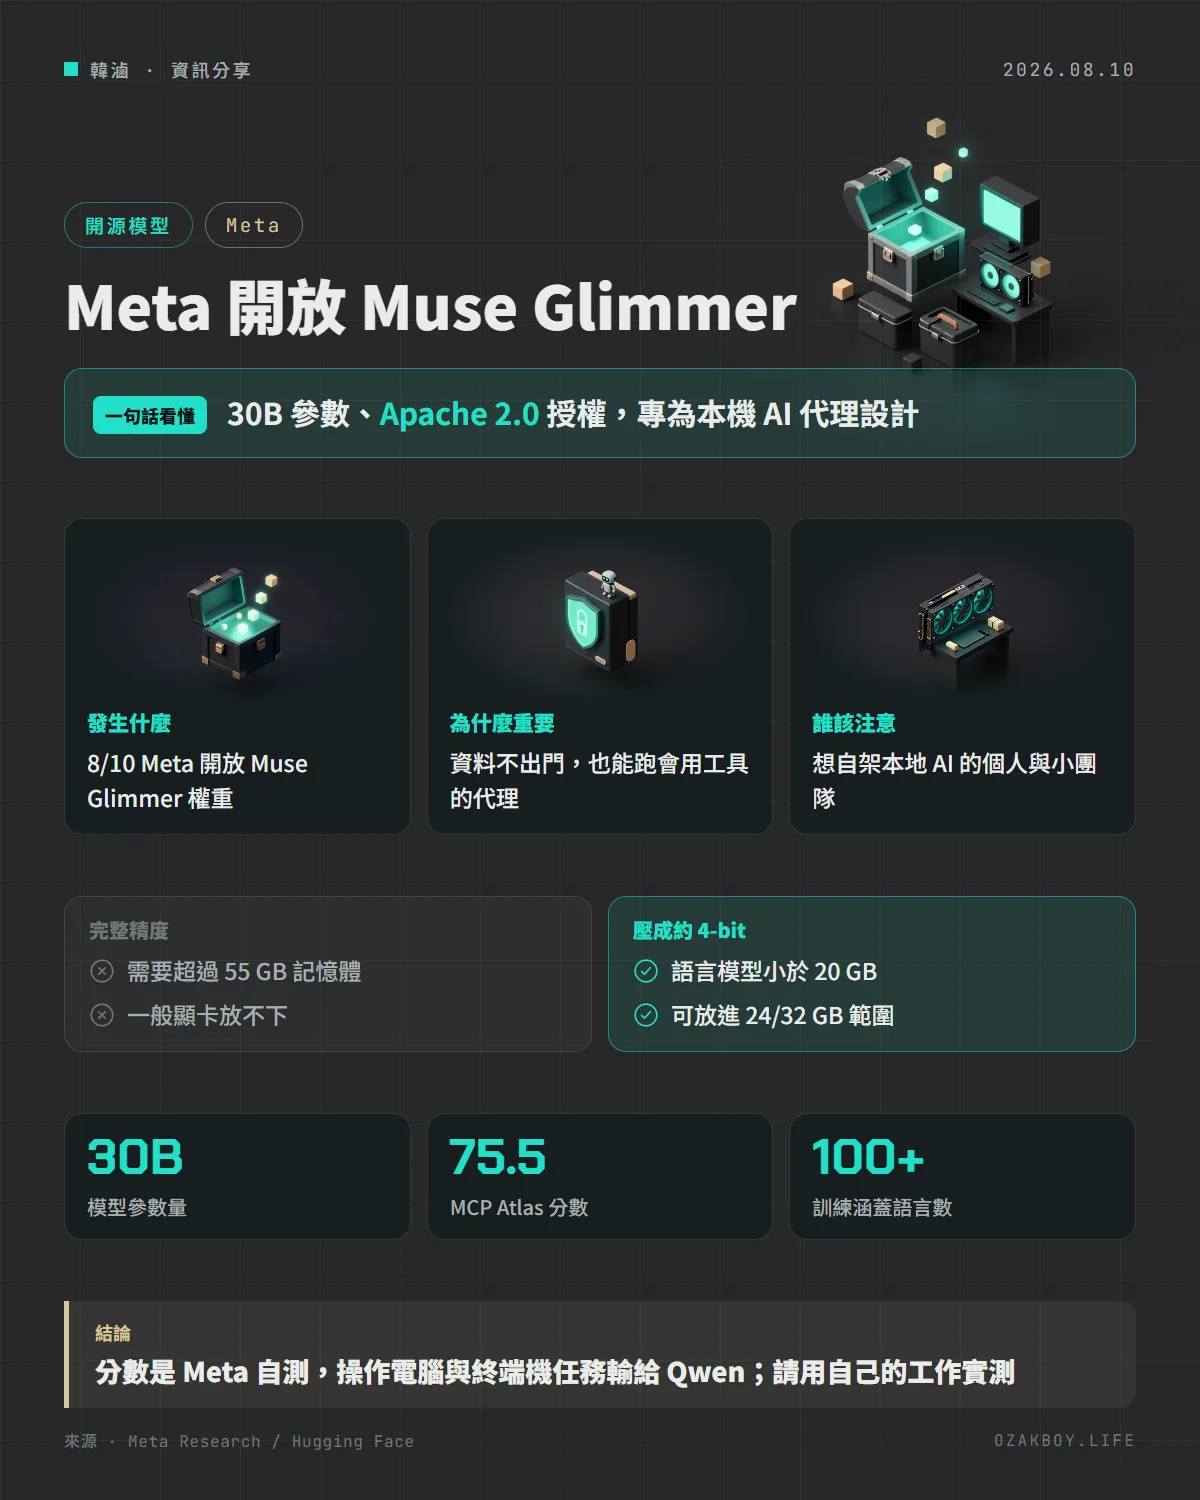
一句話看懂:Meta 在 8 月 10 日開放 Muse Glimmer 的模型權重,30B 參數、Apache 2.0 授權,專為「在自己電腦上跑 AI 代理」設計,一張消費級顯卡就放得下。
先用白話講:這是什麼模型?
想像 AI 有「大腦在雲端」和「大腦在自己家」兩種。雲端版很強,但每次問問題都要把資料送出去、還要付錢;放在自己電腦上的版本,資料不出門、沒網路也能用,只是通常比較笨。
Muse Glimmer 是 Meta 做的「放得進自己電腦的聰明大腦」:它是從 Meta 更大的 Muse Spark 模型「蒸餾」出來的,也就是讓大模型當老師,教一個小很多的學生模型,目標是保留做事的能力(呼叫工具、寫程式、看圖),但體積縮到一般玩家的顯卡能負擔。
發生什麼事
- Meta 在 8 月 10 日宣布開放 Muse Glimmer 的權重,授權是寬鬆的 Apache 2.0,可在 Hugging Face 下載
- 規格:30B 參數的稠密(dense)模型,由 2B 的視覺編碼器加 28B 的文字解碼器組成,能接受文字與圖片;官方說訓練資料涵蓋超過 100 種語言
- 定位是「隨時待命的本機代理」:本機代理、函式呼叫、本機寫程式,以及拿來當評分模型
- 官方說明會在接下來幾天,透過 Ollama、LM Studio、Unsloth 等夥伴,以及 llama.cpp、MLX、ExecuTorch 等框架提供優化整合;也可用 vLLM、SGLang 部署
要多大的電腦才跑得動?
Meta 在官方文章給了很具體的說法:
| 項目 | 官方說法 |
|---|---|
| 完整精度需要的記憶體 | 超過 55 GB |
| 壓成約 4-bit 之後的語言模型 | 小於 20 GB |
| 連同 KV 快取、視覺編碼器與加速用小模型 | 可放進 24 GB 或 32 GB 的範圍 |
| 官方量測的機器 | MacBook M4-Max、M5-Max 與 RTX 5090 |
官方還附了一個基於 DFlash 的「草稿小模型」做推測解碼:由小模型一次猜一整段字,大模型再快速檢查,讓產生速度更快、輸出品質不變。這個小模型是選用的,要多吃一點記憶體。
成績單:跟同尺寸的比
下面是 Hugging Face 文章轉載的對照表(分數是 Meta 自己發表的,對手是 Gemma4-31B 與 Qwen3.6-27B 的思考模式):
| 測驗 | Muse Glimmer | Gemma4-31B | Qwen3.6-27B |
|---|---|---|---|
| MCP Atlas(工具使用) | 75.5 | 54.2 | 62.5 |
| SWE-Bench Pro(寫程式) | 51.2 | 36.9 | 50.2 |
| SWE-Bench Verified(寫程式) | 76.0 | 66.6 | 77.2 |
| OSWorld-Verified(操作電腦) | 65.9 | 58.5 | 75.6 |
| TerminalBench 2.1(終端機任務) | 51.7 | 43.4 | 60.7 |
可以看到,它在工具使用上領先很多,但在操作電腦、終端機任務上,Qwen3.6-27B 反而比較高。所以不是「全面最強」。
給開發者的技術細節
- 架構:文字解碼器為 52 層,用「三層滑動視窗(2,048 token)加一層完整注意力」的混合模式重複 13 次;採用 Gated GQA(每個 KV 頭由 16 個查詢頭共用,官方說 KV 快取可省 16 倍)與 Q-K 正規化
- 視覺:一個 2B 的 Perception Encoder 同時處理圖片與影片,影片以每秒 2 幀處理,單段最多 96 幀
- 官方說這個壓縮方式在代理任務上「幾乎沒有退步」,是 Meta 自己的驗證
- 各家本機工具的整合是「接下來幾天」才陸續到,剛釋出的當下,用 Transformers 或官方範例最穩
我的看法
我自己平常用本地 AI 的原因很單純:資料不想送出去,而且不想為每次呼叫付錢。所以這類「30B、24GB 顯卡放得下、Apache 2.0」的組合,對想自架的人是很實際的選項,尤其授權寬鬆,替客戶做內部工具也比較沒包袱。
但我會對成績單保持冷靜。這些分數是 Meta 自己的測試,而且對手的版本、設定都會影響結果;剛好在「操作電腦」和「終端機」這兩項輸給對手。比較務實的做法:等 Ollama、LM Studio 的整合出來後,拿自己真正的工作(例如公司文件整理、固定格式的程式碼產生)實測,再決定要不要換。
名詞小辭典
- 開放權重(Open weights):公開模型的參數檔,讓人可以下載到自己的機器執行,但不一定公開訓練資料與程式碼。
- 蒸餾(Distillation):讓大模型當老師,教出一個小很多但保留大部分能力的學生模型。
- 量化(Quantization):把模型的數字用更少位元儲存,換取更小的體積與更省的記憶體。
- 推測解碼(Speculative decoding):用小模型先猜、大模型再驗證,加快文字產生速度。