觀點 · 資訊分享
Google 讓 AI 代理在程式碼送出前就抓漏洞:每月擋下數百個,還開源了工具 Mantis
Google 公開內部做法:每一次程式碼送出前,都由 AI 代理即時掃描漏洞、驗證是否真的打得到,再自動產生修補交給人審。官方說每月因此擋下數百個漏洞,並把多代理審查工具 Mantis 開源。
- 發布
- 2026-09-20
- 篇幅
- 約 4 分鐘 · 1,764 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
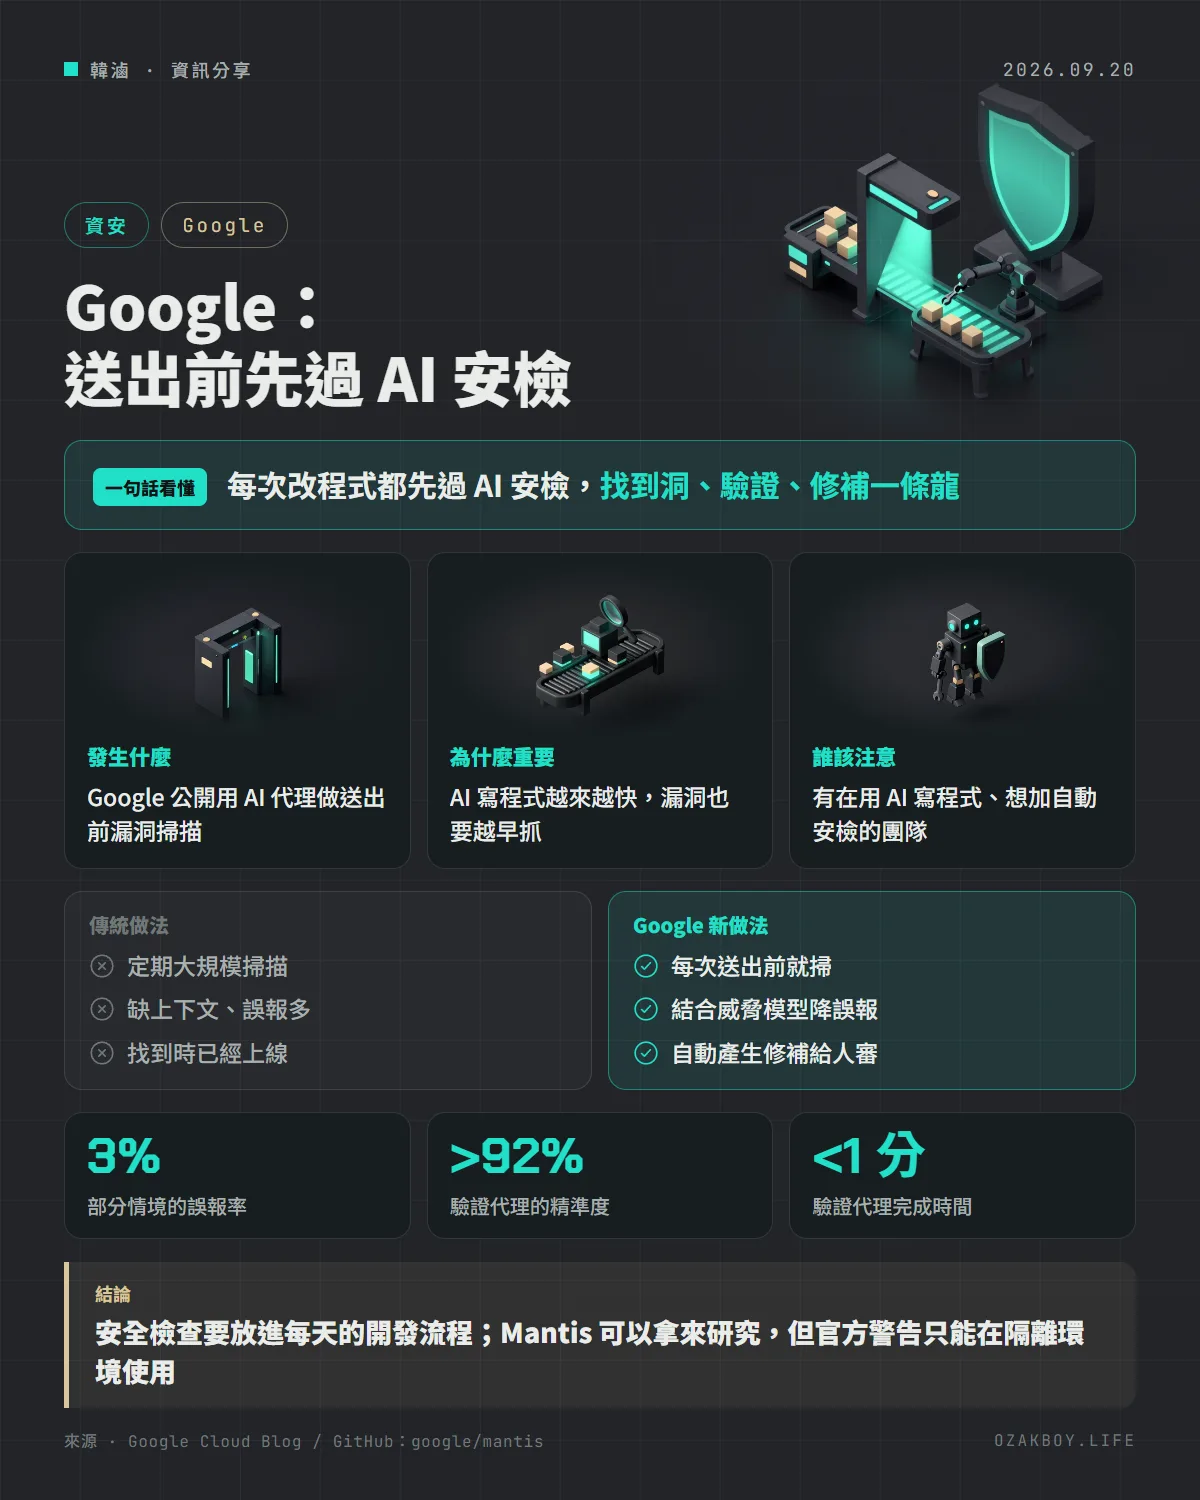
一句話看懂:Google 讓 AI 代理在每一次程式碼送出前就掃描漏洞、確認打不打得到、再自動產生修補,官方說每月因此擋下數百個漏洞。
先用白話講:「送出前掃描」是什麼?
想像一間大型工廠,以前的品管方式是每隔幾個月把整座倉庫的貨全部翻出來檢查一次。問題是,等到檢查時,有瑕疵的商品早就出貨了。
Google 現在的做法比較像在生產線上每一站都裝攝影機:每做好一個零件,就立刻檢查有沒有問題,有問題當場退回修好,才放行到下一站。
在軟體開發裡,這叫 送出前掃描(pre-submit scanning):工程師每次要把程式碼送進主程式之前,AI 代理就先檢查一遍有沒有安全漏洞。
發生什麼事
Google 的 AI 與基礎設施團隊在 9 月 19 日的 Google Cloud 部落格公開這套做法:
- 持續掃描數億行部署到 Google 基礎設施上的程式碼變更
- 官方表示每個月擋下數百個漏洞,不讓它們進入程式庫或正式環境
- 同時把內部使用的多代理審查工具 Mantis 開源
整套流程分成三層代理:
- 掃描代理:每次送出前即時掃描,搭配「在地威脅模型」(直接根據程式碼的實際資訊建立,而不是另外寫一份靜態文件),部分情境的誤報率降到 3%
- 驗證代理:用語法樹解析、呼叫圖追蹤等方法,確認漏洞的路徑真的能被攻擊者走到;精準度超過 92%,一分鐘內完成
- 修補代理:根據掃描結果與證明漏洞的程式片段,自動產生符合內部規範的修正,放進原本的程式碼審查裡交給人看
另外每晚還有一次送出後的整合掃描,抓「多個修改合在一起才出現」的漏洞。
為什麼要這樣做?
官方的理由很直接:AI 讓寫程式的速度越來越快,程式碼量暴增,傳統「偶爾做一次大型掃描」的方式太慢、缺乏上下文,往往發現時已經太晚。反過來,每次只檢查一小段修改,AI 需要的上下文少很多,準確度反而更高。
給開發者的技術細節
Google 整理給其他組織的四個原則:
- 系統分開:開發、掃描、驗證的代理,各自用獨立的框架、規則與上下文,避免互相影響;輕量 AI 掃描要搭配確定性的結構驗證
- 善用上下文:把現有的威脅模型交給代理,精準的上下文是降低誤報的關鍵
- 框架很重要:模型選擇固然重要,但好的多代理框架能彌補不同模型之間的差異
- 自動修補:讓代理提出修正,但保留人工審查
Mantis 的 README 有幾個一定要看的警告:
- 它會自動產生並執行程式碼,只能在隔離、受限制的環境執行,不可放在連得到正式系統、敏感資料或內網的機器上
- AI 的發現可能是幻覺,所有結果都要由資安專家人工驗證後才能回報,不要大量丟未驗證的報告給開源維護者
- 掃 PR 用的 GitHub Action 還沒有在真實專案上完整跑過,官方明說不要拿來當合併的關卡
我的看法
小團隊跟 Google 的規模差很多,但這篇點出的方向很值得參考:現在大家都用 AI 寫程式,產量變大,安全檢查也必須跟著自動化,而且要放在「送出前」,而不是上線後才補救。
實際上我會先從簡單的開始:在 PR 流程裡加上既有的靜態分析工具,再考慮讓 AI 做第二層審查。至於 Mantis,可以在獨立的虛擬機或容器裡拿自己的舊專案試跑,看看它找出的問題準不準,千萬不要直接在開發主機上跑。
名詞小辭典
- 威脅模型(Threat Model):整理「誰可能攻擊、從哪裡攻擊、會造成什麼傷害」的分析,用來決定防守重點。
- 誤報(False Positive):工具說有漏洞,但其實沒有;誤報太多會讓工程師不再相信警告。
- 語法樹(AST):把程式碼拆解成樹狀結構,讓工具能精準分析程式的邏輯。
- 人工把關(Human-in-the-loop):自動化流程中保留由人確認的步驟,避免機器直接做出錯誤決定。