觀點 · 資訊分享
少想一點也能答對:Ember-1 推理 token 少約 4 成,上架 Vercel AI Gateway
Fireworks 以 Kimi K3 為基礎訓練的推理模型 Ember-1,9 月 27 日上架 Vercel AI Gateway。官方說它在品質相近的情況下少用約 40% 的 token,目前是為期兩週起跳的研究預覽。
- 發布
- 2026-09-27
- 篇幅
- 約 3 分鐘 · 1,571 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
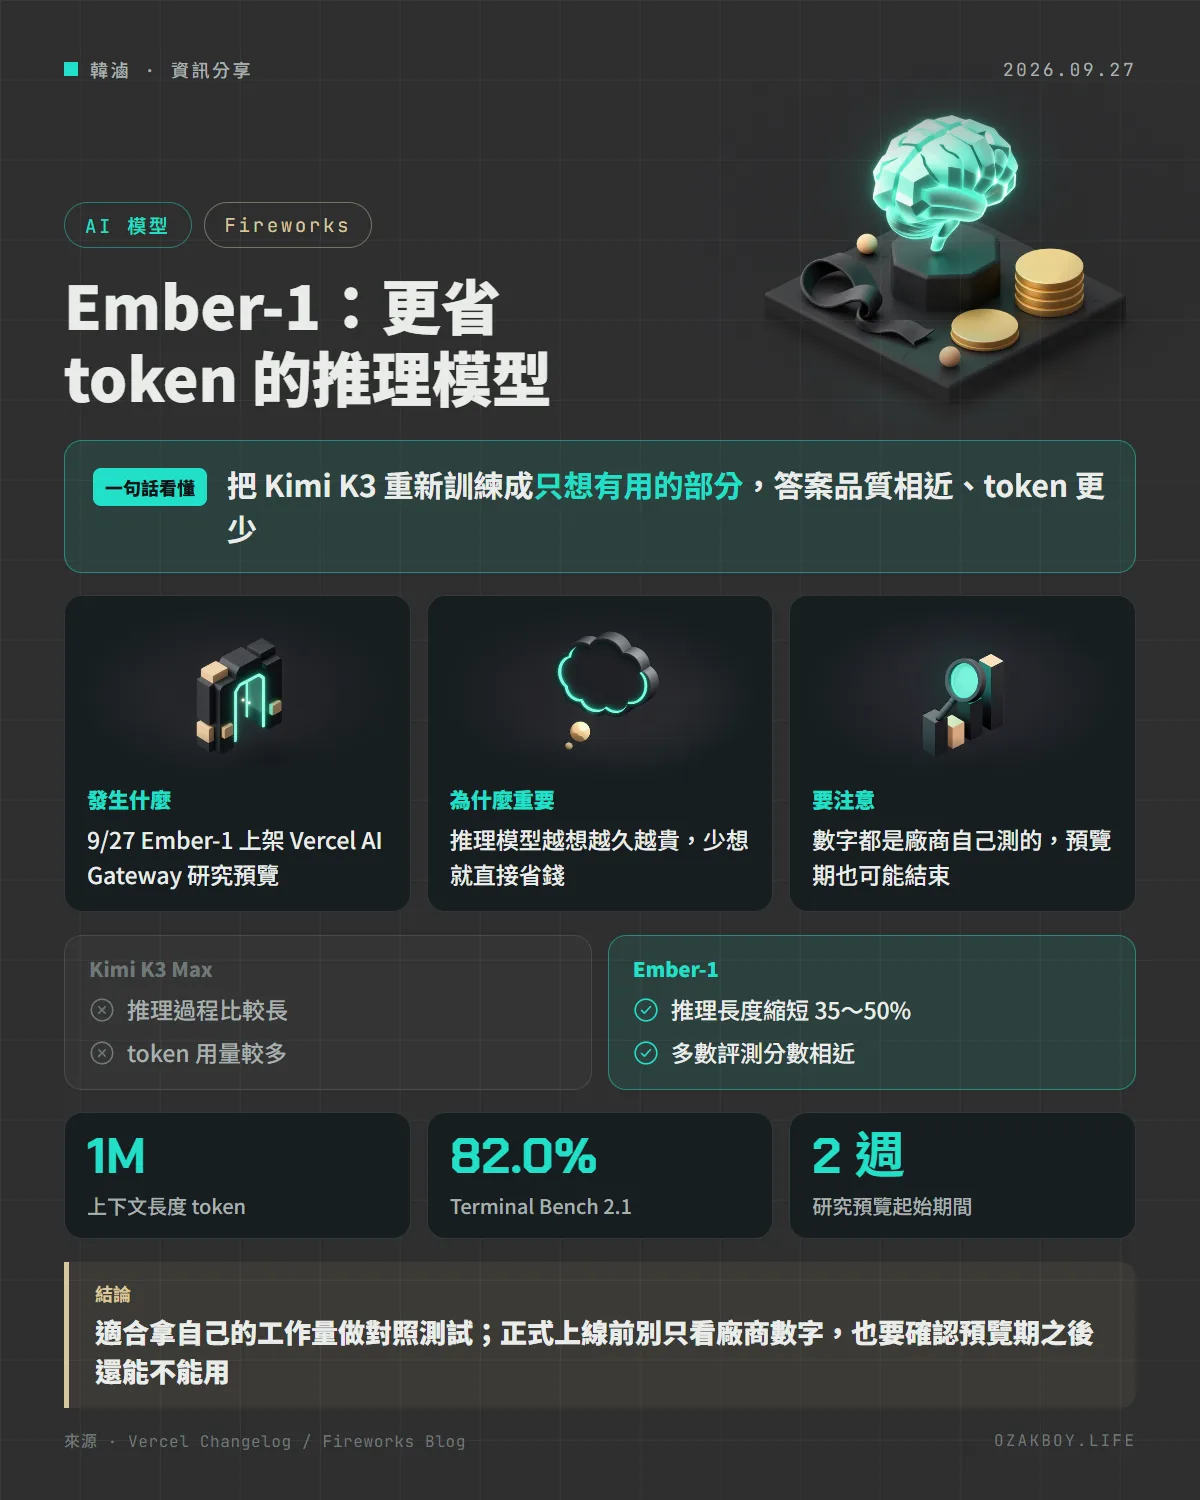
一句話看懂:Fireworks 把 Kimi K3 重新訓練成「只想有用的部分」的 Ember-1,官方說品質相近、token 少約 4 成,9 月 27 日起可以透過 Vercel AI Gateway 試用。
先用白話講:推理 token 是什麼?
現在很多 AI 模型在回答前會先「想一下」,把思考過程寫成一大段草稿,再給出答案,這段草稿就是推理 token。
問題是,AI 跟某些人一樣,有時候會想太多:同一件事反覆確認、繞遠路,最後答案其實沒變。偏偏 API 是照字數(token)收費的,想得越久,帳單就越長,等待時間也越久。
Ember-1 的目標就是教 AI「別想廢話」:保留真正有用的推理,刪掉不會改變答案的部分。
發生什麼事
- 9 月 23 日:Fireworks Research 發表 Ember-1,以 Kimi K3 為基礎再訓練,是 Ember 系列的第一個模型
- 9 月 27 日:Vercel 宣布 Ember-1 上架 AI Gateway,模型名稱
fireworks/ember-1,以研究預覽形式先開放兩週
Fireworks 公布的重點:
- 在 7 個評測和兩家客戶的實際流量上,推理長度縮短 35~50%,品質沒有明顯下降
- 程式碼工作的線上 A/B 測試,每個任務少用約 35% 的 token
- 訓練跑了 50 多次實驗、200 多次評估,用的是 Fireworks 自己的資料,不是客戶資料
跟原版比差在哪
Fireworks 公布的評測(Ember-1 對 Kimi K3 Max):
| 評測 | Ember-1 | Kimi K3 Max | token 變化 |
|---|---|---|---|
| Terminal Bench 2.1 | 82.0% | 80.9% | 少 51.9% |
| SWE-bench Verified | 92.2% | 93.2% | 少 15.5% |
| SWE-Interact | 20.0% | 21.3% | 少 32.5% |
| DeepSWE 1.1 | 75.2% | 66.4% | 少 23.7% |
可以看到有高有低,並不是每項都贏;但每一項的 token 都變少了。
給開發者的技術細節
- 上下文長度:1M token
- 輸入:文字與圖片;支援工具呼叫與隱含式提示快取
- 資料處理:Vercel 說 Fireworks 的端點支援零資料保留,也不拿提示詞訓練
- 價格:Vercel 的公告與 Fireworks 的發表文都沒有列出 Ember-1 的價格,使用前請到模型頁確認
- 權重:Fireworks 的文章沒有說明是否開放模型權重
我的看法
我很喜歡這個方向。很多時候我們不是需要「更聰明」的模型,而是「一樣聰明但不囉嗦」的模型。對每天跑大量 API 請求的服務,token 少 3、4 成就是直接省錢。
不過要保持冷靜:所有數字都是廠商自己測的,評測結果也有高有低。而且它還是研究預覽,兩週後能不能繼續用不確定。我會拿它跑自己的實際工作,對照原本的模型比成本和正確率,有明顯好處再考慮,不會一開始就把正式服務切過去。
名詞小辭典
- 推理模型:回答前會先產生一段思考過程的 AI 模型,通常比較準,但也比較貴、比較慢。
- Token:AI 計算文字量的單位,API 依 token 數量收費。
- AI Gateway:幫你統一呼叫多家 AI 模型的中介服務,可以集中管理金鑰、用量與帳單。
- 研究預覽:還在實驗階段、限期開放的版本,規格與供應狀況都可能改變。
資料來源
常見問題
Ember-1 和 Kimi K3 是什麼關係?
Ember-1 是以 Kimi K3 為基礎、由 Fireworks 再訓練的版本,不是全新架構。訓練目標是刪掉「不會改變答案」的推理步驟,讓同樣品質的回答用更少 token。
少用 token 有什麼好處?
推理模型是依 token 收費,想得越久就越貴、也越慢。在品質相近的前提下少用 token,代表每個任務的成本和等待時間都會下降。
效果一定比較好嗎?
不一定。Fireworks 公布的表格裡,Ember-1 在 Terminal Bench 2.1 與 DeepSWE 1.1 高於 Kimi K3 Max,但在 SWE-bench Verified 與 SWE-Interact 略低,而且這些都是廠商自己測的數字。
可以長期使用嗎?
目前是研究預覽。Vercel 寫的是先開放兩週;Fireworks 說研究版本會先提供兩週,再依社群需求決定是否常態提供。
接著讀
全部觀點 →Cloudflare WAF 開始檢查「伺服器回了什麼」:攻擊有沒有得逞看得出來,免費方案也能用Cloudflare 推出 WAF 完整交易偵測與回應規則,把請求和伺服器的回應放在一起判斷,在回應送出前就能攔下。所有方案(含免費)都能用,第一批受管規則針對 php2shell 漏洞。閱讀 →OpenAI API 推出 12 小時提示快取:同一段話重複問 AI,用越多次越便宜OpenAI 讓 API 可以把重複使用的提示詞「記住」12 小時(原本只有 30 分鐘)。第一次要多付一點,但同一段內容用到第 3 次就開始省錢,用 12 次大約省下 7 成。閱讀 →PHP 兩個 CVSS 9.2 遠端執行程式碼漏洞緊急修補:所有處理網頁請求的 PHP 都受影響PHP 官方修補 CVE-2026-109618 與 CVE-2026-109619,兩者 CVSS 4.0 都是 9.2,PHP-FPM、mod_php、FrankenPHP 等處理網頁請求的環境都受影響。官方說沒有完整的緩解方式,請升到 8.5.12、8.4.27、8.3.36 或 8.2.35。閱讀 →