觀點 · 資訊分享
Mistral Large 4 開放權重:1 兆參數改版 MIT 授權,2-bit 量化一台 512 GB Mac 就能跑
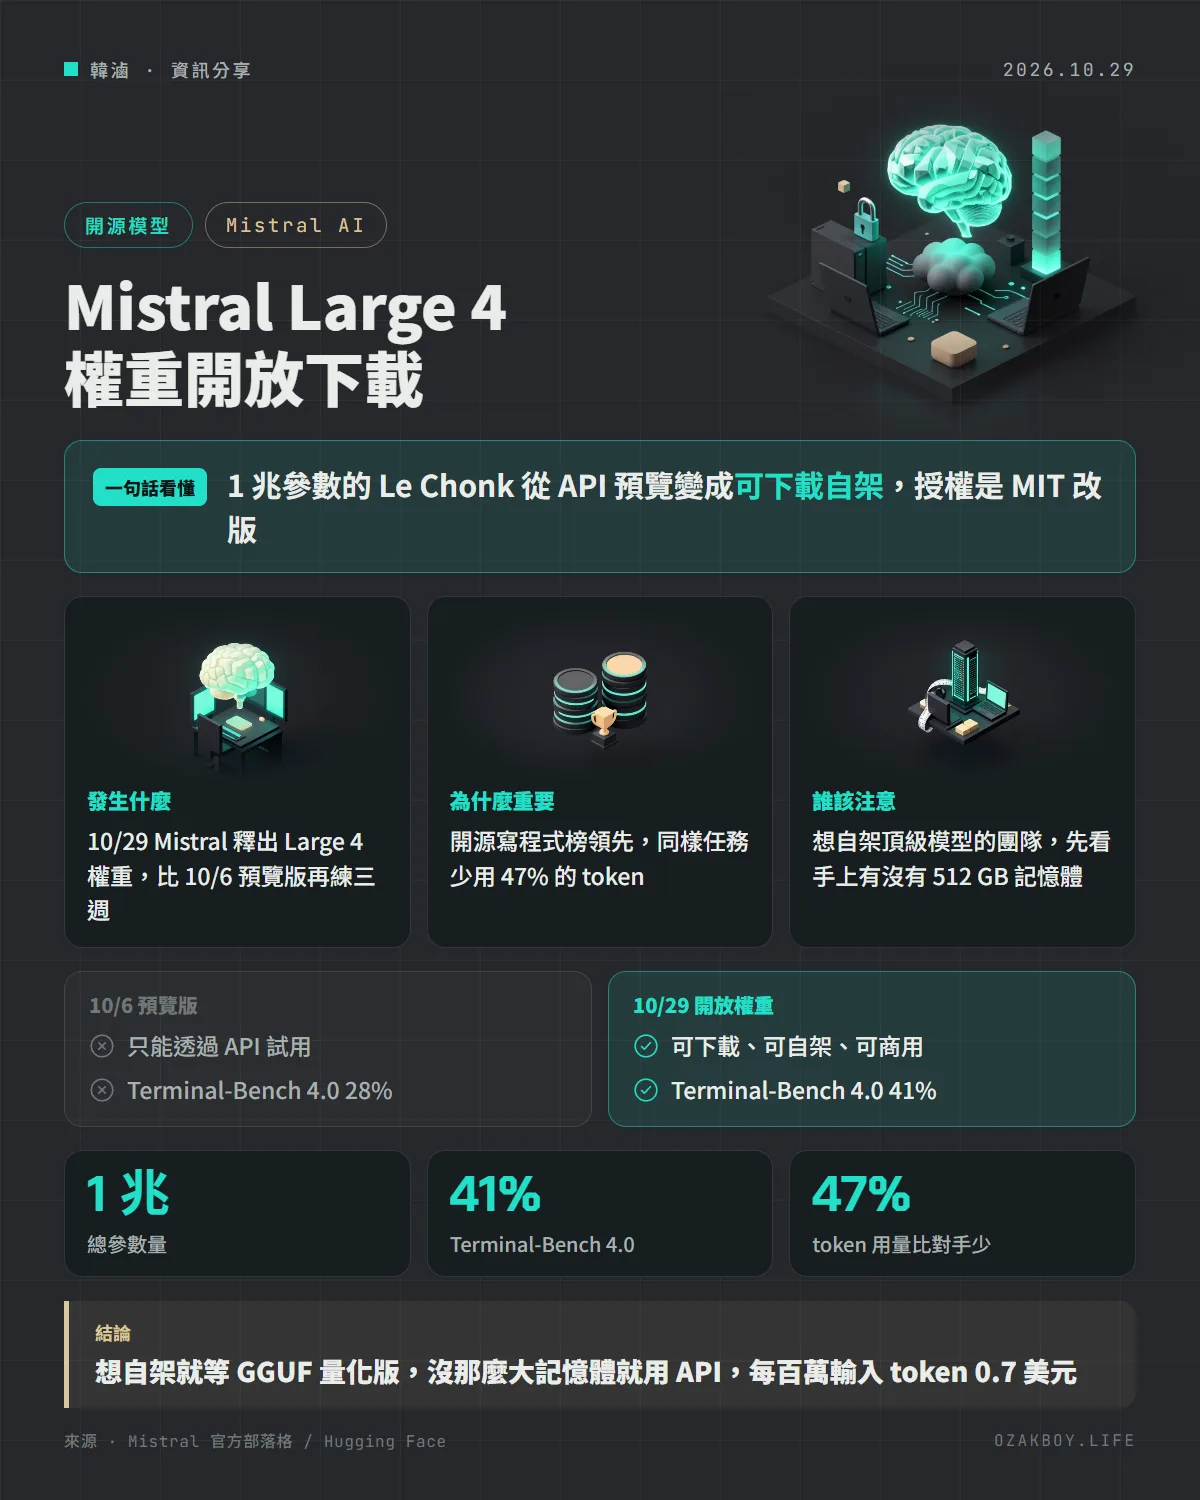
Mistral 在 10 月 29 日把 1 兆參數的旗艦模型 Mistral Large 4(綽號 Le Chonk)權重放上 Hugging Face,授權是 MIT 改版,可自架、可商用。比 10 月初的 API 預覽版多練了三週,寫程式與防守型資安是它的強項。
- 發布
- 2026-10-29
- 篇幅
- 約 5 分鐘 · 2,348 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
一句話看懂:Mistral 在 10 月 29 日把 1 兆參數的旗艦模型 Mistral Large 4(綽號 Le Chonk)權重放上 Hugging Face,授權是 MIT 改版,可自架、可商用,寫程式與防守型資安是它的強項。
先用白話講:「開放權重」是什麼?
把 AI 模型想成一位很厲害的顧問。平常你只能打電話問他(透過 API),每問一次付一次錢,他人在哪、用什麼方式回答你都管不到。
開放權重就是這位顧問把自己的「大腦」整份複製給你帶回家:你可以放在自己的機器上跑、改造他、拿公司資料再訓練,不用擔心哪天電話打不通。代價是你得自己準備一台裝得下這顆大腦的電腦。
Mistral Large 4 這顆大腦有 1 兆個參數,非常大,所以外號叫 Le Chonk(胖子)。
發生什麼事
- 10 月 6 日:Mistral 先以 API 公開預覽的形式推出 Mistral Large 4,當時就預告月底放權重
- 10 月 29 日:正式釋出權重。Mistral 說這三週又加做了強化學習,寫程式與防守型資安能力明顯提升
- 模型規格:1 兆總參數的 MoE(專家混合)架構,原生支援文字與圖片輸入,上下文 100 萬 token;官方命名 A52B,表示每個 token 只啟用約 520 億參數(Hugging Face 的文章寫約 490 億,兩邊數字略有出入)
- 授權:Mistral Ecosystem Open-Weight License,MIT 的修改版,可自由使用、修改、微調與商用,唯一條件是經營「模型即服務」的業者要另談商業授權
- API 價格:每百萬 token 輸入 0.70 美元、快取輸入 0.07 美元、輸出 2.10 美元
跟 10 月初的預覽版差在哪?
| 指標 | 預覽版 | 10/29 版本 |
|---|---|---|
| Terminal-Bench 4.0(終端機寫程式) | 28% | 41% |
| B3 代理安全(抗攻擊率) | 93.3% | 97.1% |
| FinWorkBench(財務試算表工作) | 67.4% | 73.3% |
另外依 Mistral 公布的數據:Artificial Analysis Coding Agent Index 拿 48%,與開源第一的 GLM-5.3 打平,但每個任務平均少用 47% 的 token;Cognition 的 FrontierCode 2.0 以 19.7% 居首;資安方面 Artificial Analysis Cyber Index 51%,對惡意資安請求的平均拒絕率 96.6%。
這些都是 Mistral 自己公布的數字,第三方的完整評測還要再等。
給開發者的技術細節
- 三種推理模式:Low(取代原本的 None)、Medium、High(預設),用來在成本與精準度之間取捨;Hugging Face 說明推理無法完全關閉,設 none 仍會以 High 執行
- 架構:128 個專家每次選 4 個,再加 1 個常駐共用專家;注意力用 MLA 搭配 DSA 稀疏索引;視覺編碼器是 16 億參數的 Pixtral
- 官方版本:FP8 與 NVFP4 兩種;NVFP4 在 vLLM 上需要 NVIDIA Blackwell 世代 GPU
- 量化版:llama.cpp 團隊與 Unsloth 提供 GGUF,從 IQ2_XXS、Q2_K 到 Q8_0;2-bit 版本可在一台 512 GB 統一記憶體的 Apple Silicon Ultra 上跑,Hugging Face 實測 M3 Ultra 跑 Q2_K 約每秒 15 個 token
- 第一天就支援:transformers、vLLM、llama.cpp,Mistral 也點名 SGLang;要微調就用 TRL;雲端有 Microsoft Foundry、NVIDIA NIM、Hugging Face Inference Endpoints
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
我的看法
我在家用 NAS 跑 Ollama,用的是家用等級的顯示卡,這顆 1 兆參數的模型就算壓到 2-bit 也塞不進來,所以「開放權重」對我這種規模的自架玩家,短期內的意義是「可以等更小的衍生版」,而不是今天就能跑。Mistral 也說 Large 4 會是後續一系列專門化小模型的基礎。
真正受惠的是有資料主權需求的中大型團隊:金融、政府、資安業者想把模型留在自己機房,現在多了一個歐洲訓練、授權乾淨的選項。接案的朋友如果客戶是這類單位,可以把它記下來。
另一個值得注意的是 token 效率。同樣的寫程式任務少用將近一半的 token,換算成 API 帳單就是直接省一半,對跑 agent 的人比榜單名次還實際。
名詞小辭典
- 開放權重(open weight):模型訓練完的參數檔案公開讓人下載,可以自己架設;跟「開源」不同的是訓練資料與程式不一定公開。
- MoE(Mixture of Experts):模型內部分成多位「專家」,每個字只找其中幾位回答,所以總參數很大但每次運算只用一小部分。
- 量化(quantization):把參數用更少的位元儲存,檔案與記憶體需求大幅縮小,精準度會略為下降。
- 模型即服務(Model-as-a-Service):把模型包成 API 賣給別人用的生意,這類業者使用 Mistral Large 4 要另外取得商業授權。