觀點 · 資訊分享
llama.cpp v0.9.0 釋出:支援 FP8 量化、新增 4 種模型架構,本機也能做語音合成和 40 種語言轉錄
本地跑 AI 的核心引擎 llama.cpp 推出 v0.9.0:新增 FP8 E4M3 量化格式、多人同時使用時的 KV 快取更有效率,支援 Mistral Large 4 等 4 種新架構,還加入 Chatterbox 語音合成與 Nemotron 3.5 Transcribe 語音轉文字。
- 發布
- 2026-11-04
- 篇幅
- 約 4 分鐘 · 1,671 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
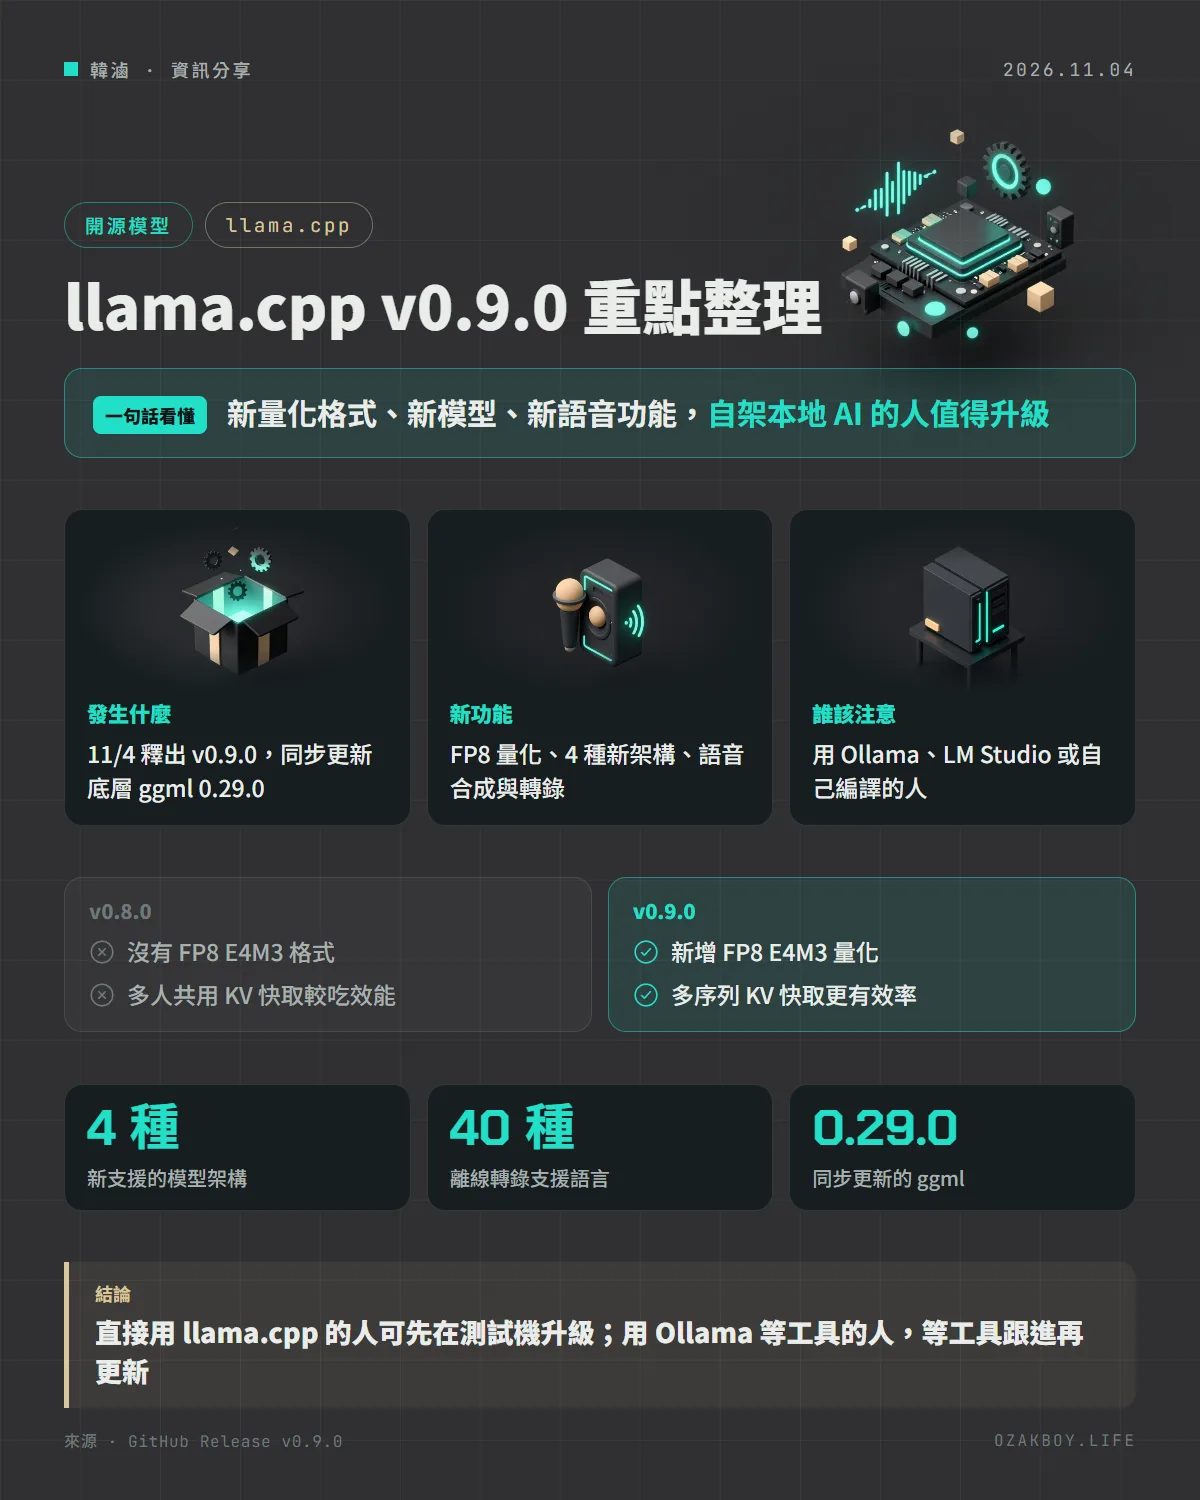
一句話看懂:本地跑 AI 的核心引擎 llama.cpp 推出 v0.9.0,新增 FP8 量化格式、4 種新模型架構,還能在本機做語音合成和 40 種語言的語音轉文字。
先用白話講:llama.cpp 是什麼?
如果把 AI 模型想成一張「食譜」,llama.cpp 就是照著食譜做菜的「廚房」。同樣一份食譜,廚房越有效率,菜就出得越快,也能用越小的爐子(越便宜的電腦)做出來。
很多人在家用的 Ollama、LM Studio 等工具,背後都跟 llama.cpp 和它的底層函式庫 ggml 有很深的關係。所以 llama.cpp 一更新,整個本地 AI 圈都會陸續受惠。
發生什麼事
llama.cpp 在 11 月 4 日釋出 v0.9.0,底層的 ggml 同步更新到 v0.29.0。重點如下:
- 新的量化格式:支援 OCP FP8 E4M3(飽和模式),並附上轉換工具
- 多人同時用更順:新增
flash_attn_ext_rows運算,讓同一台伺服器同時處理多個對話時,共用的 KV 快取更有效率 - 4 種新模型架構:Clover、Limite、Metis-1.6、Mistral Large 4
- Gemma 4 加速:E2B 和 E4B 兩個小模型的提示處理階段有大幅優化
- 語音功能:加入 Chatterbox 語音合成、Nemotron 3.5 Transcribe 語音轉文字(40 種語言、離線),以及 Pocket TTS 的預設聲音
跟上一版比差在哪
| 項目 | v0.8.0 | v0.9.0 |
|---|---|---|
| FP8 E4M3 量化 | 不支援 | 支援 |
| 多序列 KV 快取 | 較吃效能 | 新運算加速 |
| 語音轉文字 | 無 Nemotron 3.5 | 支援 40 種語言 |
| 多台機器分攤模型 | 無 NCCL 支援 | ggml 新增 NCCL 多節點張量平行 |
給開發者的技術細節
- API 變動:
llama.h新增LLAMA_FTYPE_MOSTLY_F8_E4M3;mtmd.h新增預設聲音相關 API,例如mtmd_gen_audio_voice_name() - 伺服器:
GET /props會回報模型內建的 TTS 聲音清單,TTS 端點可直接指定聲音名稱;/v1/responses現在會把 seed、min_p 等額外參數帶進轉換後的回應 - Web UI:工具設定新增 MCP 群組勾選框,工具呼叫沒有回應時會顯示「中斷」狀態
- ggml 0.29.0:CPU 新增 SVE 核心、CUDA 融合 MoE 運算、Metal 加速 MXFP4、Vulkan 調整 split-K,各後端都有效能改進
- 有自己包 Docker 映像檔的人,升級後記得重新跑一次自己的測試提示,確認輸出品質沒變
我的看法
我自己在家用 Ollama 跑本地模型,平常不太直接碰 llama.cpp,但它的更新內容幾乎就是「接下來幾個月本地 AI 能做什麼」的預告。這版最吸引我的是語音:本機就能做語音合成和多語言轉錄,代表很多原本要送到雲端的錄音檔,未來可能在自己的電腦上處理就好,對在意客戶資料隱私的案子很有幫助。
不過新格式、新模型都需要上游工具跟進,模型檔也要有人轉好。一般使用者不必急著自己編譯,等 Ollama 這類工具更新再升級比較省事;喜歡嘗鮮的人,建議先在測試機上試,別直接換掉正在服務客戶的那台。
名詞小辭典
- 量化(Quantization):把模型裡的數字用更少的位元存起來,讓模型變小、跑得更快,代價是可能略降精準度。
- FP8:用 8 個位元表示一個小數的格式,比 16 位元省一半空間。
- KV 快取:模型記住前面對話內容的暫存區,有了它就不必每次從頭重算。
- TTS / 語音轉文字:TTS 是把文字念出來,語音轉文字則是把錄音變成文字稿。
資料來源
常見問題
我用 Ollama,這次更新跟我有關嗎?
間接有關。Ollama 等工具底層會用到 llama.cpp / ggml 的成果,但什麼時候跟進、跟進哪些功能,要看各工具自己的版本更新。想馬上用新功能,就要直接用 llama.cpp。
FP8 E4M3 是什麼?要換嗎?
是一種用 8 位元存數字的格式,比常見的 16 位元省一半空間。這次 llama.cpp 開始支援這種格式的模型檔;一般使用者不必急著換,等有人釋出這種格式的模型、又確定你的硬體跑得順再說。
本機語音轉文字可以用了嗎?
這版加入 Nemotron 3.5 Transcribe 支援,可離線轉錄 40 種語言,也能參考提示內容和區分說話者。實際中文效果與速度,官方說明沒有提供數字,建議自己拿音檔測過再決定。
接著讀
全部觀點 →Mistral Large 4 開放權重:1 兆參數改版 MIT 授權,2-bit 量化一台 512 GB Mac 就能跑Mistral 在 10 月 29 日把 1 兆參數的旗艦模型 Mistral Large 4(綽號 Le Chonk)權重放上 Hugging Face,授權是 MIT 改版,可自架、可商用。比 10 月初的 API 預覽版多練了三週,寫程式與防守型資安是它的強項。閱讀 →Ollama 0.40.4:Codex CLI 可以直接挑本機模型,終端機一行指令就能讓 AI 判斷是或否Ollama 0.40.4 讓 ollama launch codex 的模型選單出現本機安裝的模型,決策模型也能直接在終端機用 ollama run 問是非題、分類與評分;另外改善推論效能、支援多模態嵌入,Gemma 4 在 NVIDIA 顯示卡上的前置處理也變快。閱讀 →vLLM 0.25.0:新執行器成為密集模型的預設,舊的 PagedAttention 實作被移除自架 AI 推理伺服器 vLLM 在 7 月 11 日釋出 0.25.0,共 558 個提交、232 位貢獻者。Model Runner V2 成為所有密集模型的預設,舊的 PagedAttention 被刪掉,Transformers 後端也追上原生速度。閱讀 →