觀點 · 資訊分享
Google 發表 Gemma 4:Apache 2.0 可商用授權,31B 版本在開源模型榜排第 3
Google 4/2 發表 Gemma 4 開源模型家族,共 4 種大小,採可商用的 Apache 2.0 授權。官方說 31B 版在 Arena 開源文字榜(4/1)排第 3,26B 版排第 6。
- 發布
- 2026-04-03
- 篇幅
- 約 3 分鐘 · 1,554 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
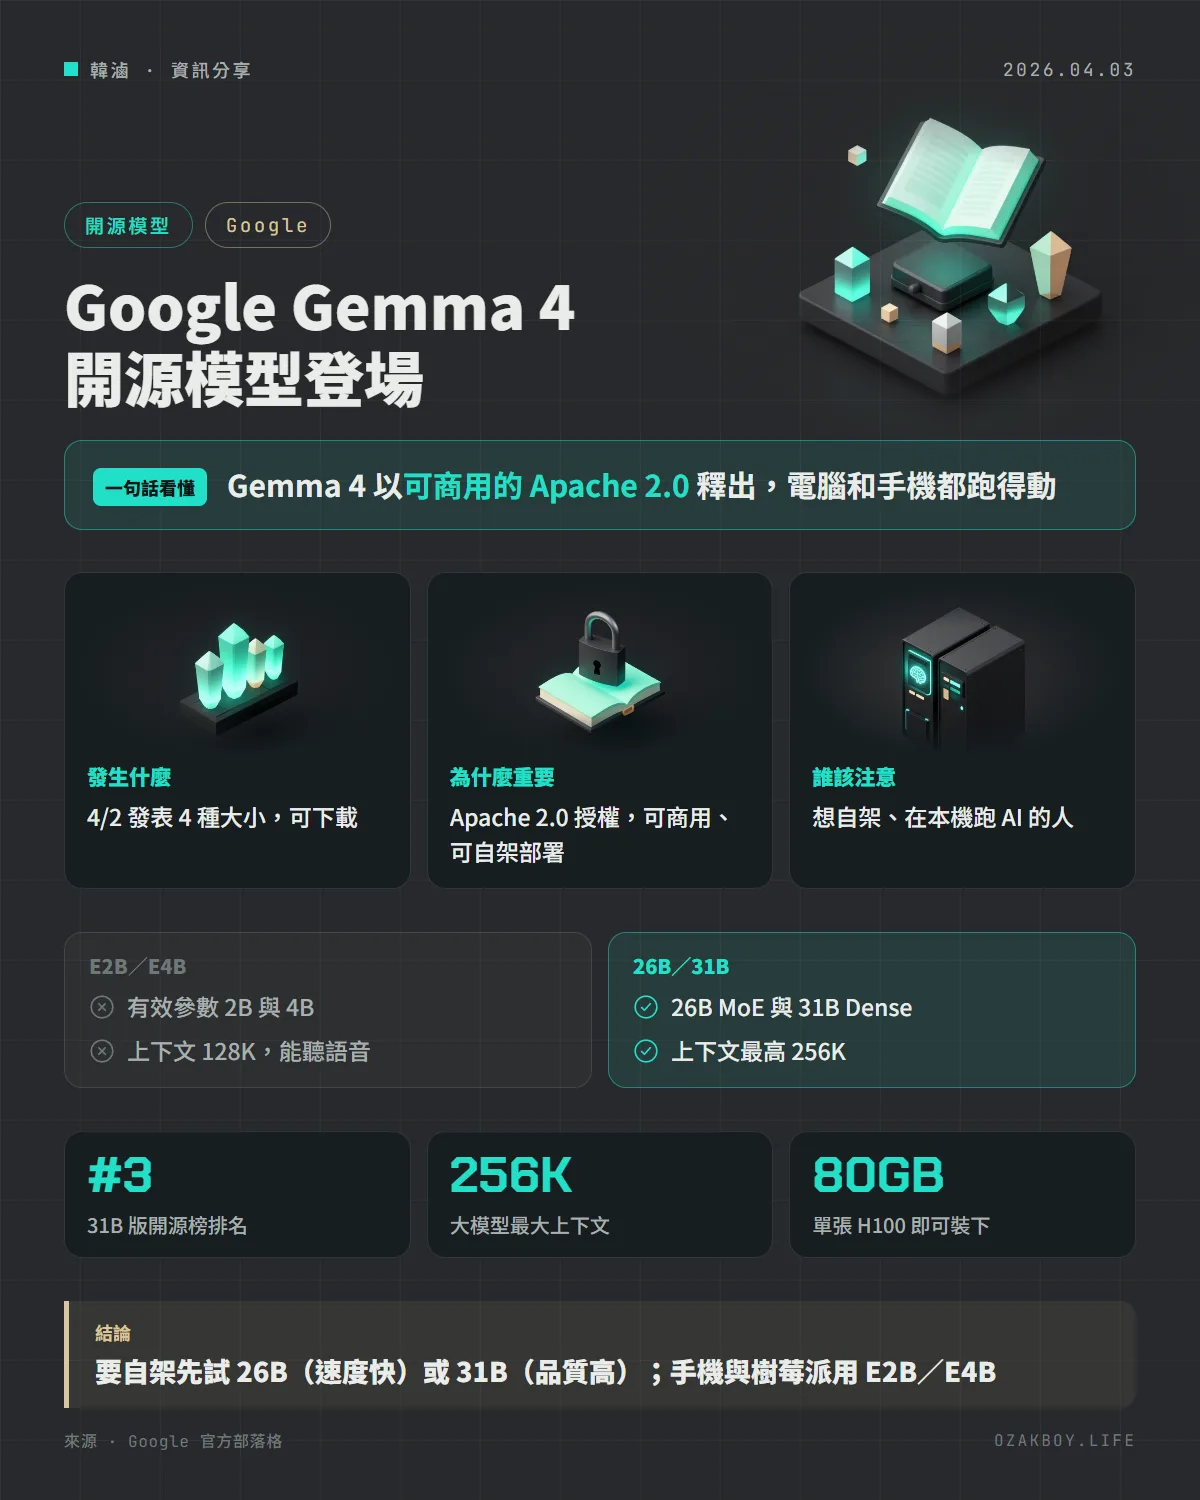
一句話看懂:Google 發表 Gemma 4 開源模型家族,共 4 種大小、採可商用的 Apache 2.0 授權,最大的 31B 版在開源模型文字榜排第 3。
先用白話講:開源模型是什麼?
想像 ChatGPT 這類服務是一家餐廳,你只能點菜、不能進廚房。開源模型則像把食譜和半成品直接給你,你可以帶回家自己煮,想怎麼調整口味都可以,資料也不用寄給別人。
Gemma 是 Google 推出的開源模型系列,Gemma 4 是最新一代。
發生什麼事
Google 在 4 月 2 日發表 Gemma 4,主打「同樣大小下最聰明」。官方提到:
- 四種大小:E2B、E4B、26B MoE、31B Dense
- 授權:Apache 2.0,官方形容為商業用途寬鬆
- 排名:31B 在 Arena AI 文字榜(截至 4/1)是全球開源模型第 3,26B 排第 6,官方並說它勝過體積 20 倍的模型
- 採用基礎:自第一代以來,Gemma 被下載超過 4 億次,衍生模型超過 10 萬個
排名是 Google 引用 Arena 的結果,時間點是 4/1,之後榜單會變動,看看就好。
四種大小怎麼選?
| 型號 | 特色 | 適合 |
|---|---|---|
| E2B、E4B | 推論時只啟動有效的 20 億、40 億參數;128K 上下文;可輸入語音 | 手機、樹莓派、NVIDIA Jetson Orin Nano |
| 26B MoE | 推論時只啟動約 38 億參數,速度快 | 重視回應速度的本機服務 |
| 31B Dense | 每次用到全部參數,品質最高,適合微調 | 重視品質的本機與伺服器 |
26B 與 31B 的上下文最高 256K,「上下文」就是 AI 一次能讀進去的內容量,256K 足以放進一個小型專案或很長的文件。
給開發者的技術細節
- 硬體需求:26B、31B 的未量化 bfloat16 權重可放進單張 80GB 的 NVIDIA H100;量化版可在消費級顯示卡上跑
- 功能:原生支援 function calling、結構化 JSON 輸出與系統指令,適合做會呼叫工具的 Agent;全系列可輸入圖片與影片;訓練語言超過 140 種
- 取得方式:權重在 Hugging Face、Kaggle、Ollama;也可以先到 Google AI Studio 試玩 31B 與 26B,E2B、E4B 可用 AI Edge Gallery
- 工具支援:官方列出首日支援 Hugging Face、llama.cpp、vLLM、Ollama、LM Studio、Unsloth、SGLang、MLX 等
我的看法
我自己有用 Ollama 在家裡跑本地模型,所以最關心的是「普通顯示卡跑不跑得動」。官方說量化版能在消費級顯示卡上跑,但沒有給出具體需要多少 VRAM,實際要看你選的量化版本,我會等社群的實測再決定。
另一個重點是授權。接案時最怕客戶問「這個模型能不能放進產品賣」,Apache 2.0 讓這個問題單純很多。不過家用 NAS 這種只有 CPU 的設備,大概只能考慮 E2B、E4B 這種小模型,而且速度要有心理準備。
名詞小辭典
- 開源模型(Open model):公開權重、可下載到自己的機器上執行與調整的 AI 模型。
- MoE(混合專家):模型內有很多「專家」,每次只叫出其中一部分工作,所以又大又快。
- 量化(Quantization):把模型的數字壓成較省空間的格式,犧牲一點精準度換取更小的體積與更快的速度。
- 上下文視窗(Context window):模型一次能讀進去並記住的內容長度上限。
資料來源
常見問題
Gemma 4 可以商用嗎?
可以。Google 說 Gemma 4 採用商業用途寬鬆的 Apache 2.0 授權,可在自家機房或雲端部署。細部條款請以官方授權文字為準。
26B MoE 和 31B Dense 差在哪?
MoE(混合專家)模型推論時只啟動一部分參數,26B 版只用約 38 億,所以速度快;Dense 模型每次用到全部參數,31B 版著重品質,也比較適合拿來微調。
要去哪裡下載?
官方列出 Hugging Face、Kaggle 與 Ollama;想先試玩可到 Google AI Studio(31B 與 26B)或 AI Edge Gallery(E4B 與 E2B)。
接著讀
全部觀點 →Ollama 0.20.5:用 ollama launch openclaw 設定聊天管道,Gemma 4 也開了 Flash AttentionOllama 0.20.5 讓你透過 ollama launch openclaw 直接設定 WhatsApp、Telegram、Discord 等聊天管道,把本地模型接進日常聊天 App;同時在相容的 GPU 上為 Gemma 4 開啟 Flash Attention。閱讀 →Flint 開源程式模型上架 Ollama:約 400 億參數、每次只動 25 億,Apache 2.0 授權Recursive 的開源程式模型 Flint 在 10 月 21 日登上 Ollama,一行指令就能在自己電腦跑。它是混合專家架構,總共約 400 億參數,處理每個 token 只動用約 25 億,下載大小 23GB。閱讀 →Ollama 0.40 在 Mac 上預設改用 MLX:本地跑 Qwen、Gemma 不用再手動切換本地 AI 工具 Ollama 發布 0.40 版,Apple Silicon 的 Mac 上只要模型架構有支援,就會自動用蘋果的 MLX 框架來跑。3 月預覽時官方測得輸出速度約快 1.9 倍。閱讀 →