觀點 · 資訊分享
Ollama 0.20.5:用 ollama launch openclaw 設定聊天管道,Gemma 4 也開了 Flash Attention
Ollama 0.20.5 讓你透過 ollama launch openclaw 直接設定 WhatsApp、Telegram、Discord 等聊天管道,把本地模型接進日常聊天 App;同時在相容的 GPU 上為 Gemma 4 開啟 Flash Attention。
- 發布
- 2026-04-10
- 篇幅
- 約 4 分鐘 · 1,655 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:Ollama 0.20.5 讓你用
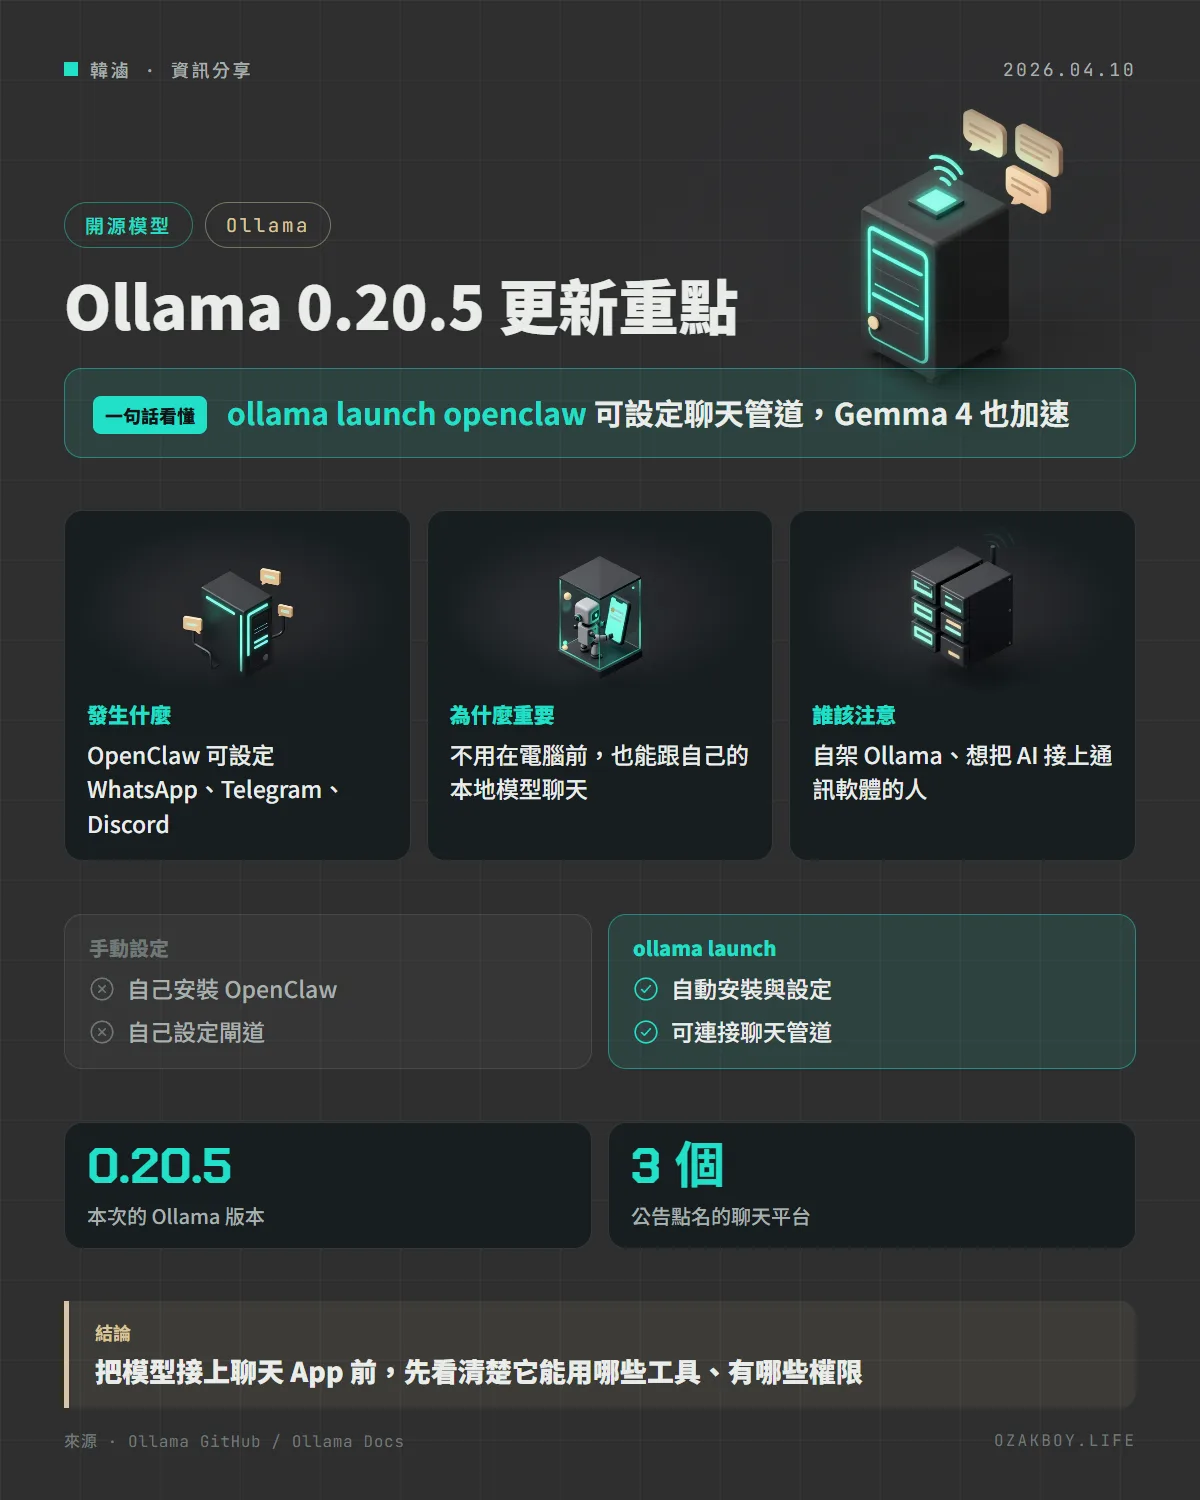
ollama launch openclaw設定 WhatsApp、Telegram、Discord 等聊天管道,把自己的本地模型接進日常聊天 App,同時也讓 Gemma 4 在相容的 GPU 上跑得更快。
先用白話講:這是在做什麼?
平常用本地模型(例如 Gemma 4),你得坐在電腦前開終端機或網頁聊天。OpenClaw 像是一個「接線生」:它跑在你自己的機器上,把你每天在用的聊天軟體(WhatsApp、Telegram、Discord 這些)跟 AI 連起來。
這次 Ollama 0.20.5 做的事,是讓你在 ollama launch openclaw 這個指令裡,直接把聊天管道設定好,不用自己東拼西湊。
發生什麼事
Ollama 在 2026 年 4 月 9 日發布 0.20.5,更新重點有:
- OpenClaw 聊天管道設定:透過
ollama launch openclaw連接 WhatsApp、Telegram、Discord 等通訊管道 - Gemma 4 加速:在相容的 GPU 上為 Gemma 4 啟用 Flash Attention
- OpenCode 偵測:
ollama launch opencode現在能偵測以 curl 安裝在~/.opencode/bin的 OpenCode - 修正:從 safetensors 匯入的模型,使用
/save指令的問題
往前看這一週,0.20.3 改善了 Gemma 4 的工具呼叫(Tool Calling)並修正 OpenClaw 啟動介面的問題;0.20.4 則提升了 M5 晶片上的 MLX 效能,並先為 Gemma 4 開啟 Flash Attention。
手動設定和 ollama launch 差在哪?
| 項目 | 手動設定 | 用 ollama launch |
|---|---|---|
| 安裝 OpenClaw | 自己用 npm 安裝 | 沒裝的話,Ollama 會詢問並幫你安裝 |
| 設定模型與閘道 | 自己逐項設定 | 選好模型後由 Ollama 設定並啟動閘道 |
| 連聊天管道 | 另外設定 | 在同一套流程中以 openclaw configure 連結 |
這張表是依官方文件的步驟整理;實際畫面與選項可能隨版本調整。
給開發者的技術細節
根據 Ollama 官方文件(後續有更新,以下為文件目前說明):
- 第一次執行
ollama launch openclaw會:透過 npm 安裝 OpenClaw、顯示工具存取風險的安全提醒、讓你選模型、完成設定並安裝閘道常駐程式 - 使用本地模型時,建議上下文長度至少 64k tokens
- 不想互動,可以用
--model搭配--yes,適合 Docker、CI/CD 或腳本 - 只想改設定、不啟動:
ollama launch openclaw --config - 用
openclaw configure --section channels連結聊天管道
我的看法
把本地模型接上聊天軟體,對自架 Ollama 的人來說很吸引人:出門在外也能問家裡那台機器。但同時也要提醒:一旦 AI 能透過聊天軟體收到指令、又有工具權限,等於在對外開一個入口。
我會先做的事:確認誰能跟這個機器人說話(不要開放給陌生人)、限縮它能用的工具,並從不重要的資料開始試。官方文件在首次啟動時特別顯示安全提醒,也是這個原因。
名詞小辭典
- Ollama:在自己電腦上執行開源語言模型的工具。
- OpenClaw:跑在你自己裝置上的個人 AI 助理,負責串接通訊軟體與 AI。
- Flash Attention:讓模型計算更省時間與記憶體的一種技術。
- 上下文長度(Context Length):模型一次能「記住」的內容量,單位是 token。