觀點 · 資訊分享
vLLM 0.20.2 小修版:補上 DeepSeek V4 卡死、gpt-oss 編譯與 Qwen3-VL 高負載的 4 個問題
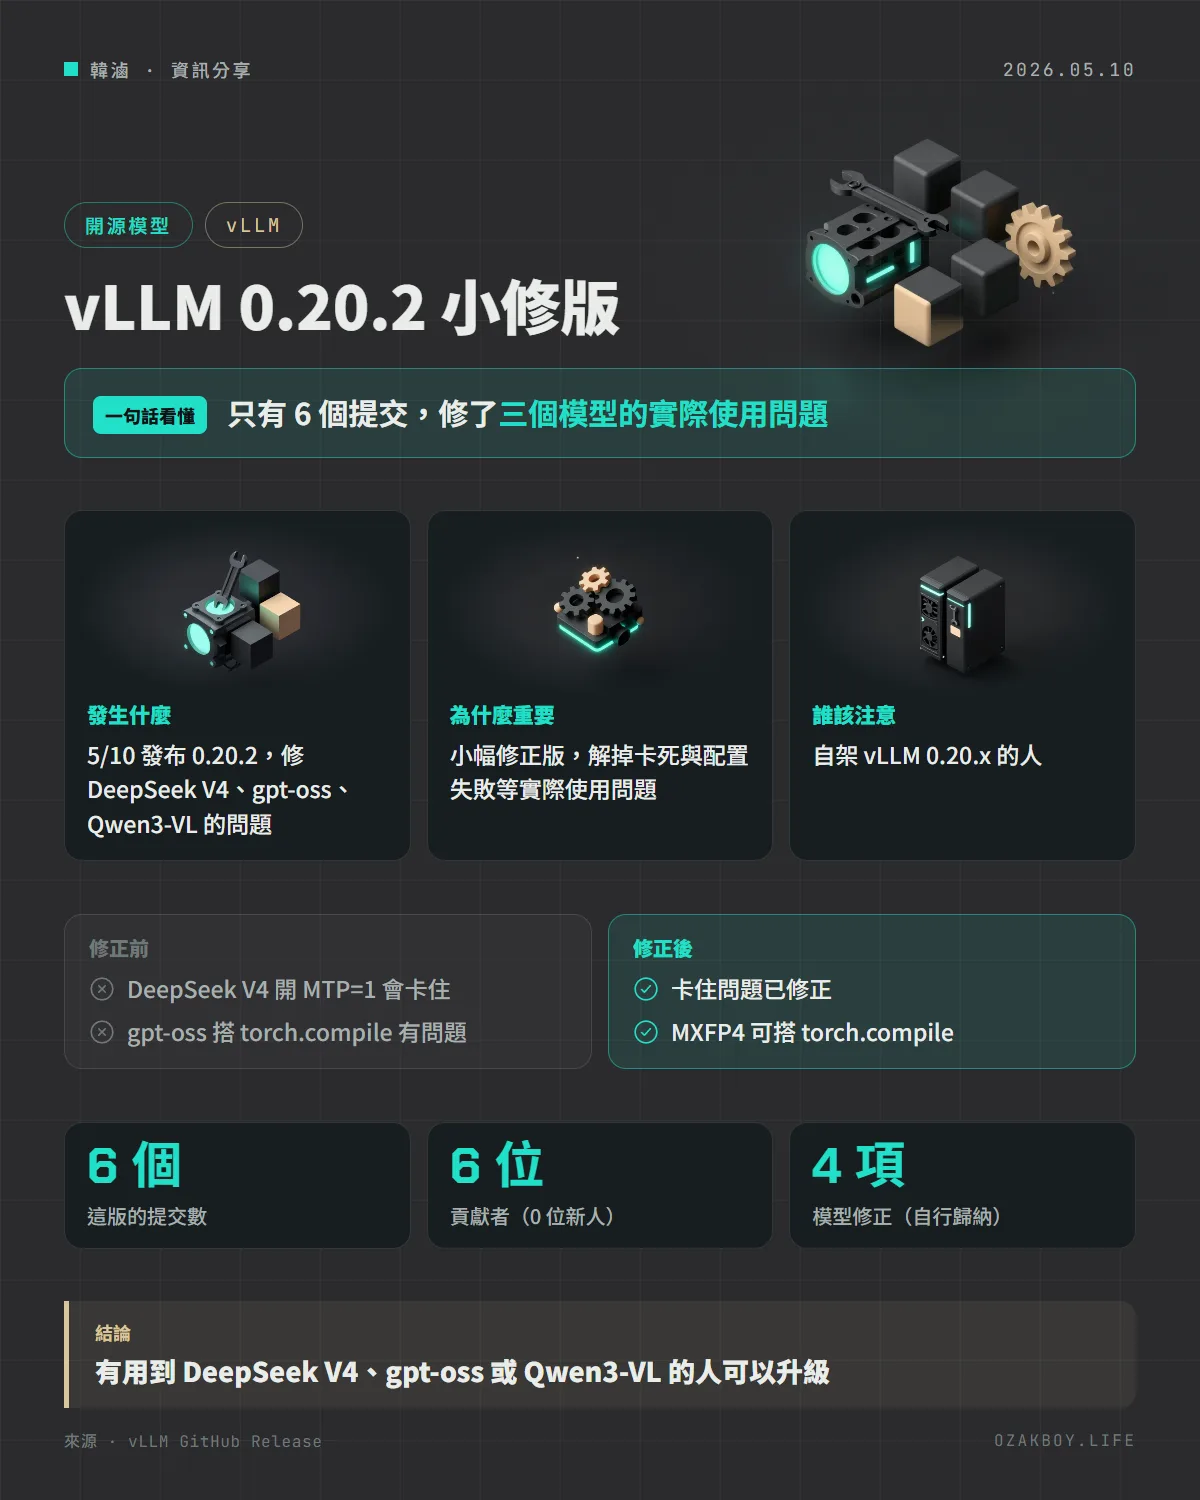
自架大型語言模型推論引擎 vLLM 在 5 月 10 日發布 0.20.2,是只有 6 個提交的小型修補版:修正 DeepSeek V4 開啟 MTP 時卡住、KV 區塊配置失敗、gpt-oss 的 MXFP4 搭配 torch.compile 與 Qwen3-VL 高負載失敗。
- 發布
- 2026-05-10
- 篇幅
- 約 3 分鐘 · 1,417 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:vLLM 0.20.2 是只有 6 個提交的小型修補版,補上 DeepSeek V4 卡住、KV 區塊配置失敗、gpt-oss 編譯與 Qwen3-VL 高負載失敗等 4 個問題。
先用白話講:vLLM 在做什麼?
如果把大型語言模型比喻成一位很會回答問題的專家,vLLM 就是替專家排隊的「櫃台」:同時有很多人來問,它負責安排誰先問、怎麼最有效率地使用顯卡。
這次是櫃台系統的小修版,修的是幾個特定專家(模型)搭配櫃台時才會出現的問題。
發生什麼事
vLLM 在 5 月 10 日發布 v0.20.2。官方說明這是一個小型修補版,有 6 個提交、6 位貢獻者(0 位新人),針對 DeepSeek V4、gpt-oss 與 Qwen3-VL 修正問題。
| 模型 | 修正內容 |
|---|---|
| DeepSeek V4(稀疏注意力) | 重新啟用 Hopper 上的 persistent topk 路徑,並確保 memset kernel 在 CUDA graph 擷取時執行,修好 MTP=1 卡住的問題 |
| DeepSeek V4(KV cache) | 修正 V1 引擎 KV cache 管理器「無法配置 KV 區塊」的錯誤 |
| gpt-oss | 讓 MXFP4 搭配 torch.compile 能正常運作 |
| Qwen3-VL | 移除一個在高負載下可能失敗的無效 deepstack 邊界檢查 |
要不要升級?
- 沒用到這三個模型:不急,可以等下一個版本一起升
- 有跑 DeepSeek V4 並開啟 MTP:這版的修正和你最相關
- 有跑 gpt-oss 並用 torch.compile:值得升級後測試
- 跑 Qwen3-VL 且流量大:官方說的是高負載下可能失敗,值得升級
給開發者的技術細節
- 官方說 DeepSeek V4 的 topk 路徑修正,本質上是「還原」先前的一個變更(公告標示為對 #41605 的 revert),代表上個版本的最佳化帶來了回歸問題,這是我的解讀
- gpt-oss 的修正是把
hidden_dim_unpadded傳進moe_forward的 fake op,並標示是 #41646 的回補 - 補丁版升級通常風險較低,但自架服務仍建議先在測試環境用自己的模型與流量跑一遍
升級前後的小檢查
- 先確認自己現在的版本是不是 0.20.x,以及正在跑哪些模型、用哪種顯卡,再對照上面的表格
- 升級後用平常的流量跑一輪,觀察還有沒有卡住或配置失敗的狀況
- 記下升級前後的版本號,萬一出問題可以快速退回去
以上三點是我的通用建議,不是官方公告的步驟。
我的看法
自架推論服務的人最怕的就是「模型一換、引擎就卡」。這種只有 6 個提交的補丁版很適合練習升級流程:先看公告,確認自己有沒有用到列出的模型,再決定升不升。
另外,這份公告提到的 DeepSeek V4 與 Hopper 顯卡,多半是資料中心等級的硬體;家用顯卡的人,通常更關心 gpt-oss 與 Qwen3-VL 這兩項。實際會不會遇到,仍要看自己的設定。
名詞小辭典
- vLLM:開源的大型語言模型推論引擎,擅長同時處理很多請求。
- KV cache:模型生成時暫存前文運算結果的記憶體,用來加快後續回應。
- MTP:多 token 預測,一次猜多個字來加速生成。
- torch.compile:PyTorch 的編譯加速功能。
資料來源
常見問題
vLLM 是什麼?
一套開源的大型語言模型推論引擎,重點是在顯卡上高效率地服務很多請求。很多人用它自架 OpenAI 相容的 API 服務。
我需要升級嗎?
如果你沒有用到 DeepSeek V4、gpt-oss 或 Qwen3-VL,這版對你影響不大。有用到的人,若遇過卡住、KV 區塊配置失敗或高負載失敗,這版是針對這些問題的修正。
MTP 與 MXFP4 是什麼?
MTP 是多 token 預測,用來加速生成;MXFP4 是一種低位元的數值格式,用來縮小模型與加速計算。公告只說這次修的是它們搭配特定模型或編譯時的問題。
接著讀
全部觀點 →vLLM 0.22.0 釋出:459 次提交,DeepSeek V4 支援更成熟、Qwen3 預設換新引擎開源 AI 推論引擎 vLLM 在 5 月 29 日釋出 0.22.0。重點包括 DeepSeek V4 的完整強化、Qwen3 密集模型預設改用 Model Runner V2、實驗性的 Rust 前端,以及多層 KV 快取卸載。閱讀 →德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。閱讀 →vLLM 公開 cache_salt 漏洞:塞一個超長字串,就能讓 AI 推論伺服器卡住所有人自架 AI 模型常用的推論引擎 vLLM,在 9 月 12 日公開一則安全公告:請求裡的 cache_salt 欄位沒有長度上限,沒登入的人送出超大字串,就能拖慢排程、讓其他請求排隊。0.29.0 以上已修正。閱讀 →