觀點 · 資訊分享
SGLang 0.5.12 發布:完整支援 DeepSeek V4,新增 Blackwell 的 TokenSpeed MLA 後端與多款新模型
開源推論框架 SGLang 在 5 月 16 日發布 0.5.12,主打完整支援 DeepSeek V4(含多種平行化與 B300/GB300 等硬體),也新增 Blackwell 專用的 TokenSpeed MLA 注意力後端,以及 Intern-S2、MiniCPM-V 4.6 等模型。
- 發布
- 2026-05-17
- 篇幅
- 約 3 分鐘 · 1,499 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
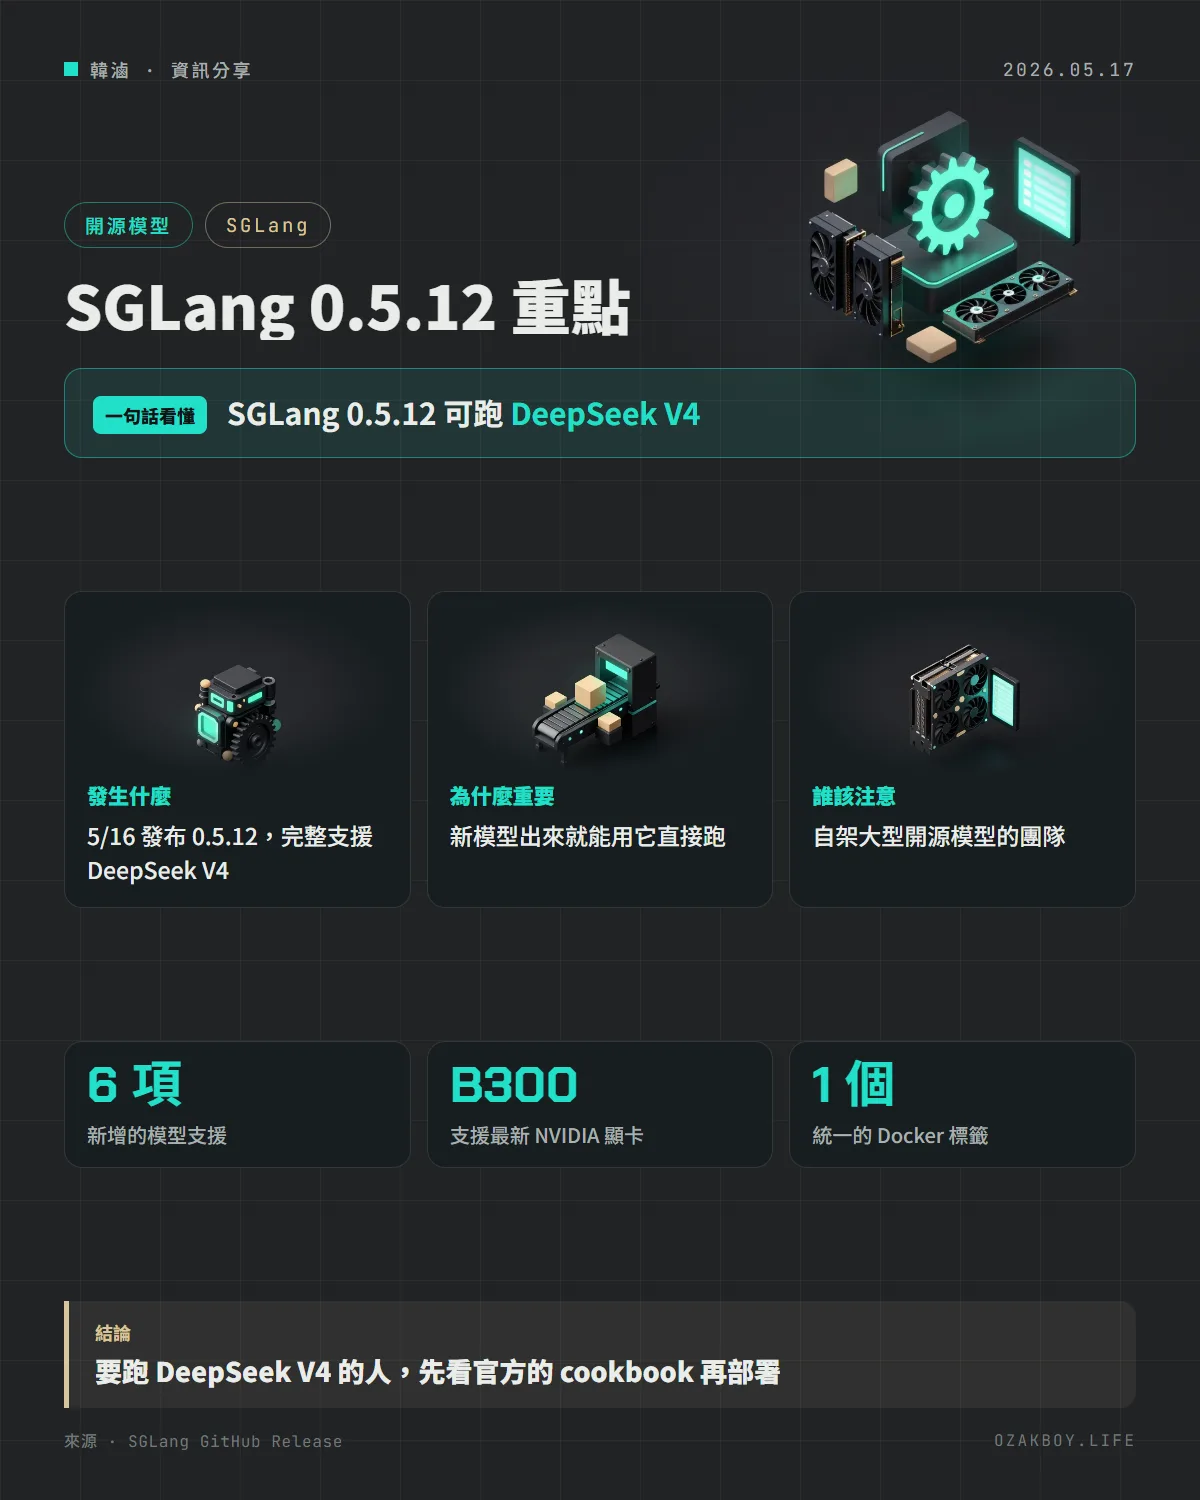
一句話看懂:開源推論框架 SGLang 發布 0.5.12,主要賣點是完整支援 DeepSeek V4,另外新增 Blackwell 專用的注意力後端與多款新模型。
先用白話講:SGLang 是什麼?
想像你開了一間很受歡迎的麵店,客人一多,廚房就會塞車。SGLang 就像一套聰明的出餐調度系統:它不是廚師本人,而是幫「AI 模型」這位大廚安排接單順序、共用備料、讓很多客人同時被服務,並且在新菜單(新模型)出現時,第一時間讓大廚能上手。
發生什麼事
SGLang 在 5 月 16 日發布 0.5.12。官方列出的重點:
- 完整支援 DeepSeek V4:包含張量平行、專家平行、上下文平行、資料平行注意力,以及預填與解碼分離
- 支援的硬體:NVIDIA B300、B200、H200、H100、GB200、GB300,以及 AMD MI35X
- HiSparse:把不活躍的 KV 快取卸載到 CPU 記憶體,幫忙節省顯示卡記憶體
- TokenSpeed MLA 注意力後端:用在 Blackwell(SM100)上,支援 FP8 的 KV 快取,目標是低延遲的 MLA 服務
- 統一的 Docker 標籤:
lmsysorg/sglang:v0.5.12適用所有 NVIDIA 顯卡
新增的模型支援
| 模型 | 備註 |
|---|---|
| DeepSeek V4 | 有官方 cookbook 與 LMSYS 部落格說明 |
| Intern-S2-Preview | 有 cookbook |
| MiniCPM-V 4.6 | 有 cookbook |
| Laguna-XS.2(Poolside) | 有 cookbook |
| Ring-2.6-1T(InclusionAI,兆級參數推理模型) | 有 cookbook |
| Gemma 4 MTP | Gemma 4 的 MTP 預測頭 |
其他值得看的改動
- HiCache 與統一基數樹:支援更多快取管理,並修了多個驅逐、回放等穩定性問題
- 推測式解碼 V2 成熟化:加入自適應模式、EAGLE-3 的新草稿模型支援、Gemma 3/4 搭配 EAGLE-3 等
- CUDA 13 的 DeepEP 遷移:改用官方分支,讓預設 CUDA 13 環境能順利編譯與執行
給開發者的技術細節
- 官方把 DeepSeek V4 的部署細節放在 cookbook(docs.sglang.io/cookbook),實際指令與顯示卡配置要以那邊為準
- 官方列了很多效能優化的項目(例如 W4A4 MegaMoE 核心、W4A8 MoE 核心),這份發布說明沒有提供統一的基準數字,實際速度請自己測試
- 這份 release notes 很長,涵蓋很多模型與硬體的細節,升級前建議完整讀過再動手
我的看法
我自己是用 Ollama 跑本地模型,這種等級的大型 DeepSeek V4 離一般家用電腦很遠,不是我會直接用的東西。
但看這類推論框架的發布,我會留意兩件事:一是「新模型出來多久後有人支援」,這決定你想用某個開源模型時要等多久;二是統一的 Docker 標籤這種小事,其實很實用,因為自架最麻煩的常常是環境對不上。如果你的團隊要自架大型開源模型,SGLang 與 vLLM 是兩個值得同時評估的選項。
名詞小辭典
- 推論(Inference):讓訓練好的模型實際回答問題的過程。
- KV 快取:模型回答時暫存的中間資料,對話越長佔用越多記憶體。
- 預填與解碼分離:把處理輸入與產生輸出分給不同機器做,提高整體效率。
- MLA:一種降低記憶體用量的注意力機制設計。
資料來源
常見問題
SGLang 是什麼?
一套開源的大型語言模型推論與服務框架,用來讓模型更快、更有效率地同時回應很多請求,性質跟 vLLM 類似。
DeepSeek V4 的支援有哪些內容?
官方列出:多種平行化方式、預填與解碼分離、把不活躍的 KV 快取卸載到 CPU 記憶體的 HiSparse、推理與工具呼叫解析器,以及專用的 DeepGemm、FlashMLA 核心。
我需要升級嗎?
如果你要在 SGLang 上跑 DeepSeek V4 或這版新增的其他模型,需要升級;沒有這類需求的話,不一定要馬上換。升級前建議先看官方 release notes 的完整內容。
接著讀
全部觀點 →SGLang 0.5.16:新推測解碼 DSpark 讓 DeepSeek-V4-Pro 單請求每秒 383.7 token開源推理引擎 SGLang 釋出 0.5.16,加入依信心調整猜字長度的 DSpark 推測解碼,支援 975B 參數的 Inkling 模型,也有省記憶體的新選項。同時移除多個量化路徑,升級前要看破壞性變更。閱讀 →SGLang 0.5.14 一次支援 7 個新模型:GLM-5.2、Kimi-K2.7-Code 都在內,MoE 負載平衡也加了新招開源的模型服務引擎 SGLang 在 6/26 釋出 0.5.14,新增 GLM-5.2、Kimi-K2.7-Code、DiffusionGemma 等 7 個模型支援,並加入 Waterfill 與 LPLB 兩種 MoE 負載平衡方法。閱讀 →vLLM 0.22.0 釋出:459 次提交,DeepSeek V4 支援更成熟、Qwen3 預設換新引擎開源 AI 推論引擎 vLLM 在 5 月 29 日釋出 0.22.0。重點包括 DeepSeek V4 的完整強化、Qwen3 密集模型預設改用 Model Runner V2、實驗性的 Rust 前端,以及多層 KV 快取卸載。閱讀 →