觀點 · 資訊分享
SGLang 0.5.14 一次支援 7 個新模型:GLM-5.2、Kimi-K2.7-Code 都在內,MoE 負載平衡也加了新招
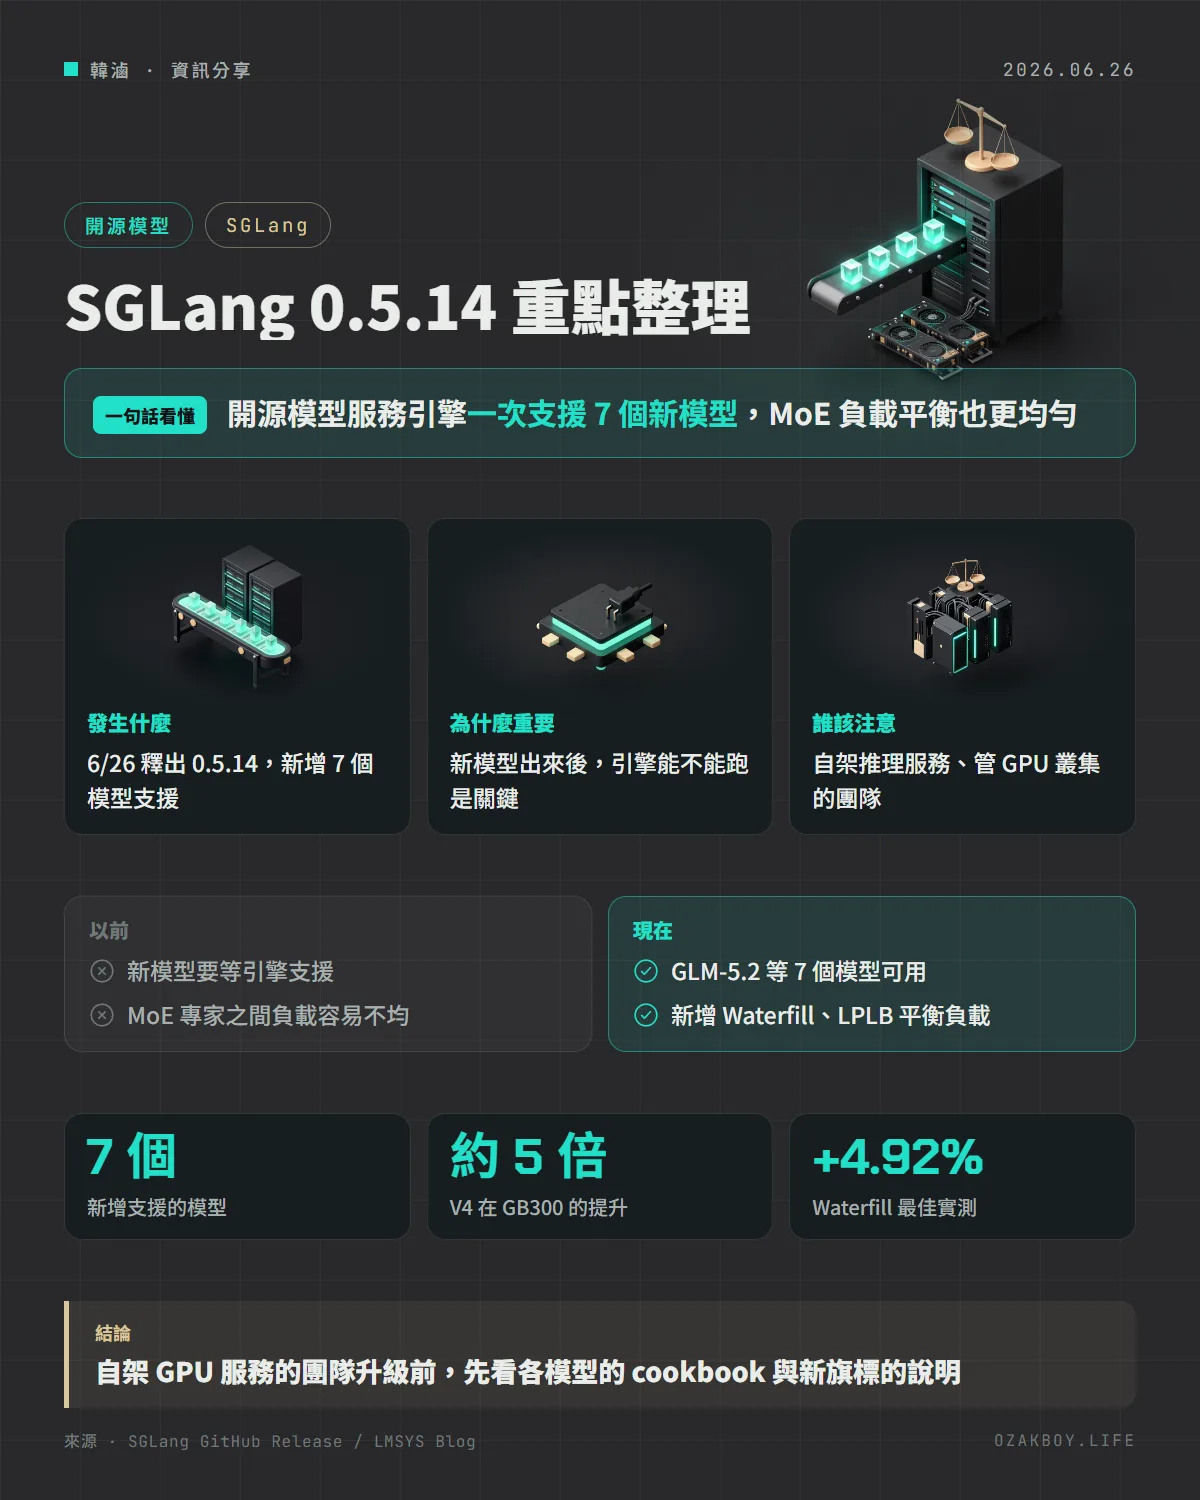
開源的模型服務引擎 SGLang 在 6/26 釋出 0.5.14,新增 GLM-5.2、Kimi-K2.7-Code、DiffusionGemma 等 7 個模型支援,並加入 Waterfill 與 LPLB 兩種 MoE 負載平衡方法。
- 發布
- 2026-06-26
- 篇幅
- 約 5 分鐘 · 2,102 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:開源的模型服務引擎 SGLang 在 6 月 26 日釋出 0.5.14,一次新增 7 個模型支援,也加入兩種讓 MoE 模型「分工更平均」的新方法。
先用白話講:SGLang 是什麼?
如果把 AI 模型比喻成一位大廚,SGLang 就是整間餐廳的「出菜系統」:決定客人點的菜怎麼排隊、怎麼同時開火、怎麼讓廚房最忙也不出錯。模型再強,沒有好的出菜系統,客人一多就會塞住。
這類工具叫做「推理引擎」,主要給要架設自己的 AI 服務、有多張 GPU 的團隊使用。
發生什麼事
SGLang 團隊在 6 月 26 日釋出 0.5.14。最容易看懂的是新增支援 7 個模型:
| 模型 | 備註 |
|---|---|
| GLM-5.2 | 有官方使用手冊(cookbook) |
| LiquidAI LFM2.5 | 有 cookbook |
| Kimi-K2.7-Code | 有 cookbook |
| Poolside Laguna-M.1 | 有 cookbook |
| DiffusionGemma | 有 cookbook |
| Zyphra ZAYA1 | cookbook 還在準備 |
| MiMo-V2-ASR | cookbook 還在準備 |
兩個新的負載平衡招式
MoE(混合專家)模型每次只叫幾位專家來答題。如果某幾位被叫得太頻繁,整體速度就被最忙的那位拖慢。0.5.14 加入兩種平衡方法,LMSYS 也同步發表了說明與實測:
- Waterfill:把「共用專家」的工作分給比較不忙的 GPU。在兩個 Hopper GPU 節點上,跑 DeepSeek-V3/R1 類型的工作負載,吞吐量提升 1.48% 到 4.66%;在 DeepSeek V4 上,最好的實測點從 49,253 提升到 51,677 tok/s(約 +4.92%)
- LPLB:用線性規劃替每一層算出最平均的分配方式,要加旗標
--ep-dispatch-algorithm=lp才會啟用,預設行為不變。同樣環境下提升 0.84% 到 7.34%
這些數字都是 LMSYS 部落格自己測的,條件是特定 GPU 與測試項目,換環境結果會不同。
給開發者的技術細節
- DeepSeek-V4 在 GB300 的提升:釋出說明連到 PyTorch 部落格,文中比較的是 4 月首發版本(未使用 MTP)與 6 月版本(使用 MTP):每張 GPU 在約每位使用者 50 tok/s 的互動速度下,從約 2,200 提升到約 11,200 tok/s。這是 4 月到 6 月一連串優化的結果,不是 0.5.14 單一版本的成果
- 新增的 NVFP4 MoE 路徑:DeepSeek-V4 在 Blackwell 上可用
--moe-runner-backend flashinfer_trtllm_routed啟用 - Kimi-Linear 的新預填核心:在 Blackwell(SM100)上比 Triton 路徑快 1.08 到 1.52 倍
- 線性注意力模型的快取更省:用 int8 存放遞迴狀態,讓前綴快取可以放更多;推測解碼用的中間快取去除重複後,佔用空間減半
- AMD 與 NPU:可中斷的 CUDA graph 可在 ROCm/HIP 上跑;多項 Ascend NPU 支援也有更新
- 釋出說明的「安全性」欄寫明這個版本沒有被標為安全性修正的變更
我的看法
我自己在本機用的是 Ollama、ComfyUI 這類輕量工具,用不到 SGLang,但它的更新節奏很值得看:一個新模型出來,能不能「Day-0 支援」,已經變成推理引擎的競爭重點。一次支援 7 個模型,代表開源生態更新速度比以前快很多。
另一個提醒:看到「5 倍」這種數字,要先弄清楚比較的是什麼。這次是從 4 月首發到 6 月累積的成績,而且用了不同的解碼設定,不能直接解讀為「升級 0.5.14 就快 5 倍」。如果你要自架服務,建議先用自己的模型與流量實測,再決定要不要升級。
名詞小辭典
- 推理引擎(Inference Engine):負責在 GPU 上實際跑模型、回應請求的軟體,像 SGLang、vLLM。
- MoE(Mixture of Experts,混合專家):把模型拆成多位「專家」,每次只啟動其中一部分,省算力又能放大模型規模。
- tok/s:每秒輸出多少個 token(文字片段),越高代表吞吐量越大。
- MTP(多 token 預測):一次猜好幾個接下來的字再驗證,用來加速生成。