觀點 · 資訊分享
SGLang v0.5.13:猜字加速改成預設,Nemotron 3 Ultra 與多款生圖模型同步支援
開源推論引擎 SGLang 發布 v0.5.13,把第二代推測解碼(Spec V2)改成預設,並新增 Nemotron 3 Ultra、Step-3.7-Flash 與多款擴散模型的支援。
- 發布
- 2026-06-14
- 篇幅
- 約 3 分鐘 · 1,402 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
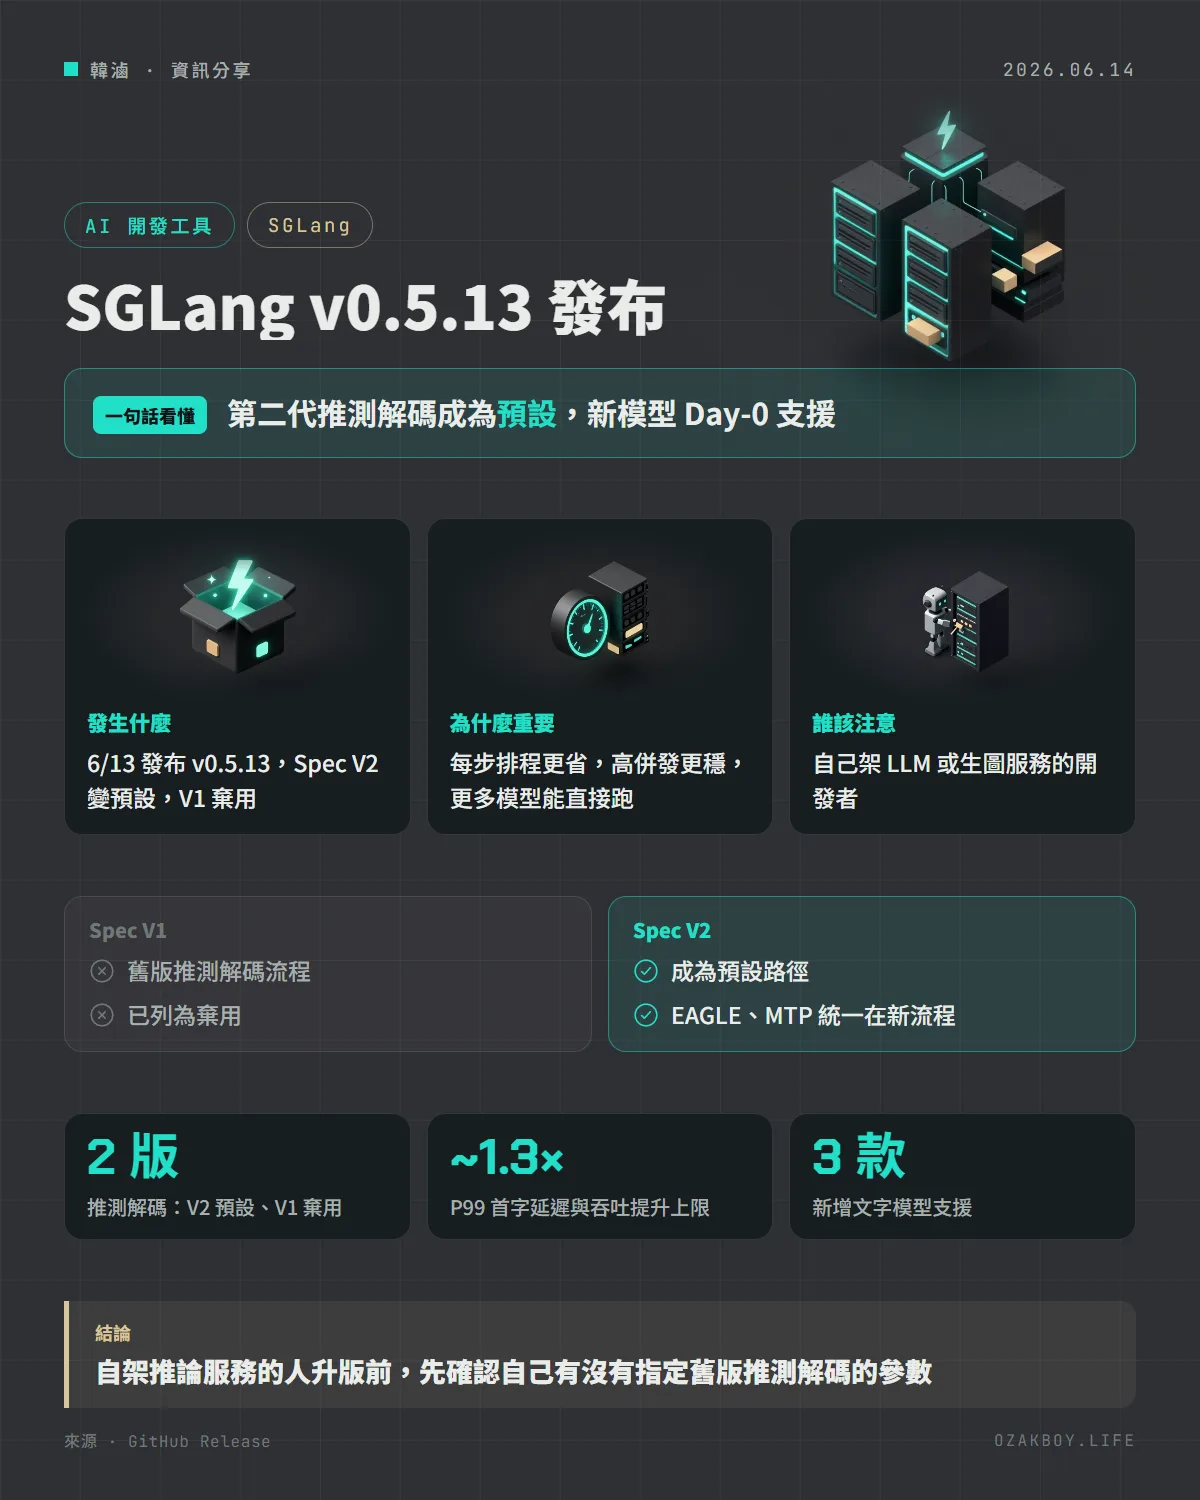
一句話看懂:SGLang v0.5.13 把第二代推測解碼改成預設,並一次支援多款新模型,自架 AI 服務的人升版前值得看一眼。
先用白話講:推論引擎在做什麼?
模型檔案像一本很厚的食譜,推論引擎則是廚房的出菜系統:負責把客人(使用者請求)的點單排好順序,讓廚師(GPU)盡量不閒著、不出錯。SGLang 就是這種開源的出菜系統,自己架 LLM 服務的人常用它。
發生什麼事
SGLang 在 2026 年 6 月 13 日發布 v0.5.13。官方列出的重點:
- 新模型:Nemotron 3 Ultra(Day-0,發布當天就支援)、Step-3.7-Flash、Command A+
- 新的擴散(生圖、影像)模型:Cosmos3、LingBot-World、SANA-WM、Ernie-Image、FLUX.2-Klein 4B/9B、Ideogram 4
- Spec V2 成為預設的推測解碼路徑,Spec V1 被棄用;EAGLE 與 MTP 現在跑在統一的 V2 流程上
- 每步排程開銷更低:高併發下啟動開銷下降、穩定度提升
- CUDA Graph 涵蓋更廣:分段式與可中斷式兩種擷取,擴大到 DSA 模型、Kimi-K2.5 與 DeepSeek V4
其他值得看的更新
- Qwen 3.5 在 Blackwell 上更快:新增 FlashInfer 的 Gated DeltaNet 核心與 CuTeDSL 預填核心
- 混合模型預設啟用 HiCache:滑動視窗與 Mamba 類混合模型,開箱即有階層式 KV 快取卸載
- Intel 合作的 CPU + GPU 分工:把視覺模型的編碼交給 Xeon CPU,官方說 P99 首字延遲與請求吞吐量最多約提升 1.3 倍(官方的說法是「up to」,條件以其部落格為準)
給開發者的技術細節
- 推測解碼(Speculative Decoding):先猜後驗證,topk 大於 1 的樹狀草稿在多種後端已可用於正式環境
- 若你的啟動腳本明確指定舊的 Spec V1 流程,升級後可能需要調整;官方 release 把 V1 標為棄用,沒有在摘要中說明移除時間
- 官方公告也提到 AMD Instinct MI355X 上的 MoRI 相關更新,內容在公告中被截斷,細節請看原頁面
- 建議:升版前先在測試環境,用自己的模型與流量跑一次壓測,確認吞吐量與輸出品質
我的看法
我在家用 NAS 與一張顯示卡跑本地模型,平常不會直接碰到這種等級的引擎,但從這類更新可以看出一個趨勢:加速技巧正在從「進階選項」變成「預設值」。對自架服務的人來說,好處是不用再研究一堆開關;風險是升版後行為可能悄悄改變,所以變更記錄一定要讀。
另外,新模型 Day-0 支援很實用:想試新模型的人不必等好幾週,但實際效果與穩定度,仍建議自己測過再上線。
名詞小辭典
- 推論(Inference):模型訓練好之後,拿來回答問題、產生內容的過程。
- 推測解碼:先用輕量方法猜幾個字,再讓大模型一次驗證,猜中就能加速。
- CUDA Graph:把一連串 GPU 操作錄下來重播,減少每次啟動的額外開銷。
- P99 首字延遲:100 個請求裡,第 99 慢的那個等多久才看到第一個字,用來衡量服務在尖峰時夠不夠穩。
資料來源
常見問題
SGLang 是什麼?
一套開源的大型語言模型推論引擎,用來把模型包成高效能的服務,常和 vLLM 一起被拿來比較。
推測解碼是什麼?
讓一個小模型先快速猜接下來幾個字,再由大模型一次驗證,猜對的部分就能省下逐字運算的時間。EAGLE、MTP 都是這類做法。
升到 v0.5.13 要注意什麼?
Spec V2 變預設、Spec V1 棄用。如果你的啟動參數有指定舊的推測解碼流程,升級前先看官方 release 說明確認相容性,並自己跑一次壓測。
接著讀
全部觀點 →SGLang 0.5.16:新推測解碼 DSpark 讓 DeepSeek-V4-Pro 單請求每秒 383.7 token開源推理引擎 SGLang 釋出 0.5.16,加入依信心調整猜字長度的 DSpark 推測解碼,支援 975B 參數的 Inkling 模型,也有省記憶體的新選項。同時移除多個量化路徑,升級前要看破壞性變更。閱讀 →vLLM 0.29 把新執行器 MRV2 設為所有模型的預設:舊版預計 0.32 移除,指令與預設值也有調整開源推論引擎 vLLM 發布 0.29.0:新一代執行器 Model Runner V2 成為所有模型的預設,舊版 MRV1 進入棄用、目標 0.32 移除。同時調整多項預設值,也有幾個指令與環境變數被移除。閱讀 →llama.cpp 加入 DFlash 推測解碼:本機跑大模型最高快約 8 倍,但要看模型與題目本機跑模型的核心工具 llama.cpp 在 6/28 合併 DFlash 推測解碼:讓小模型一次猜一整段字,大模型再批次檢查。PR 實測 Qwen3-8B 最高快 8.08 倍,但開啟思考或換成 MoE 模型時,加速有限,甚至會變慢。閱讀 →