觀點 · 資訊分享
Z.ai 開源 GLM-5.2:能讀 100 萬 token、MIT 授權,寫程式測試 81.0 分逼近 Opus 4.8
Z.ai 發表新旗艦模型 GLM-5.2,權重公開下載、採 MIT 授權,上下文從 20 萬拉到 100 萬 token。官方自己公布的寫程式成績明顯進步,但數字尚待外部實測。
- 發布
- 2026-06-18
- 篇幅
- 約 5 分鐘 · 2,070 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
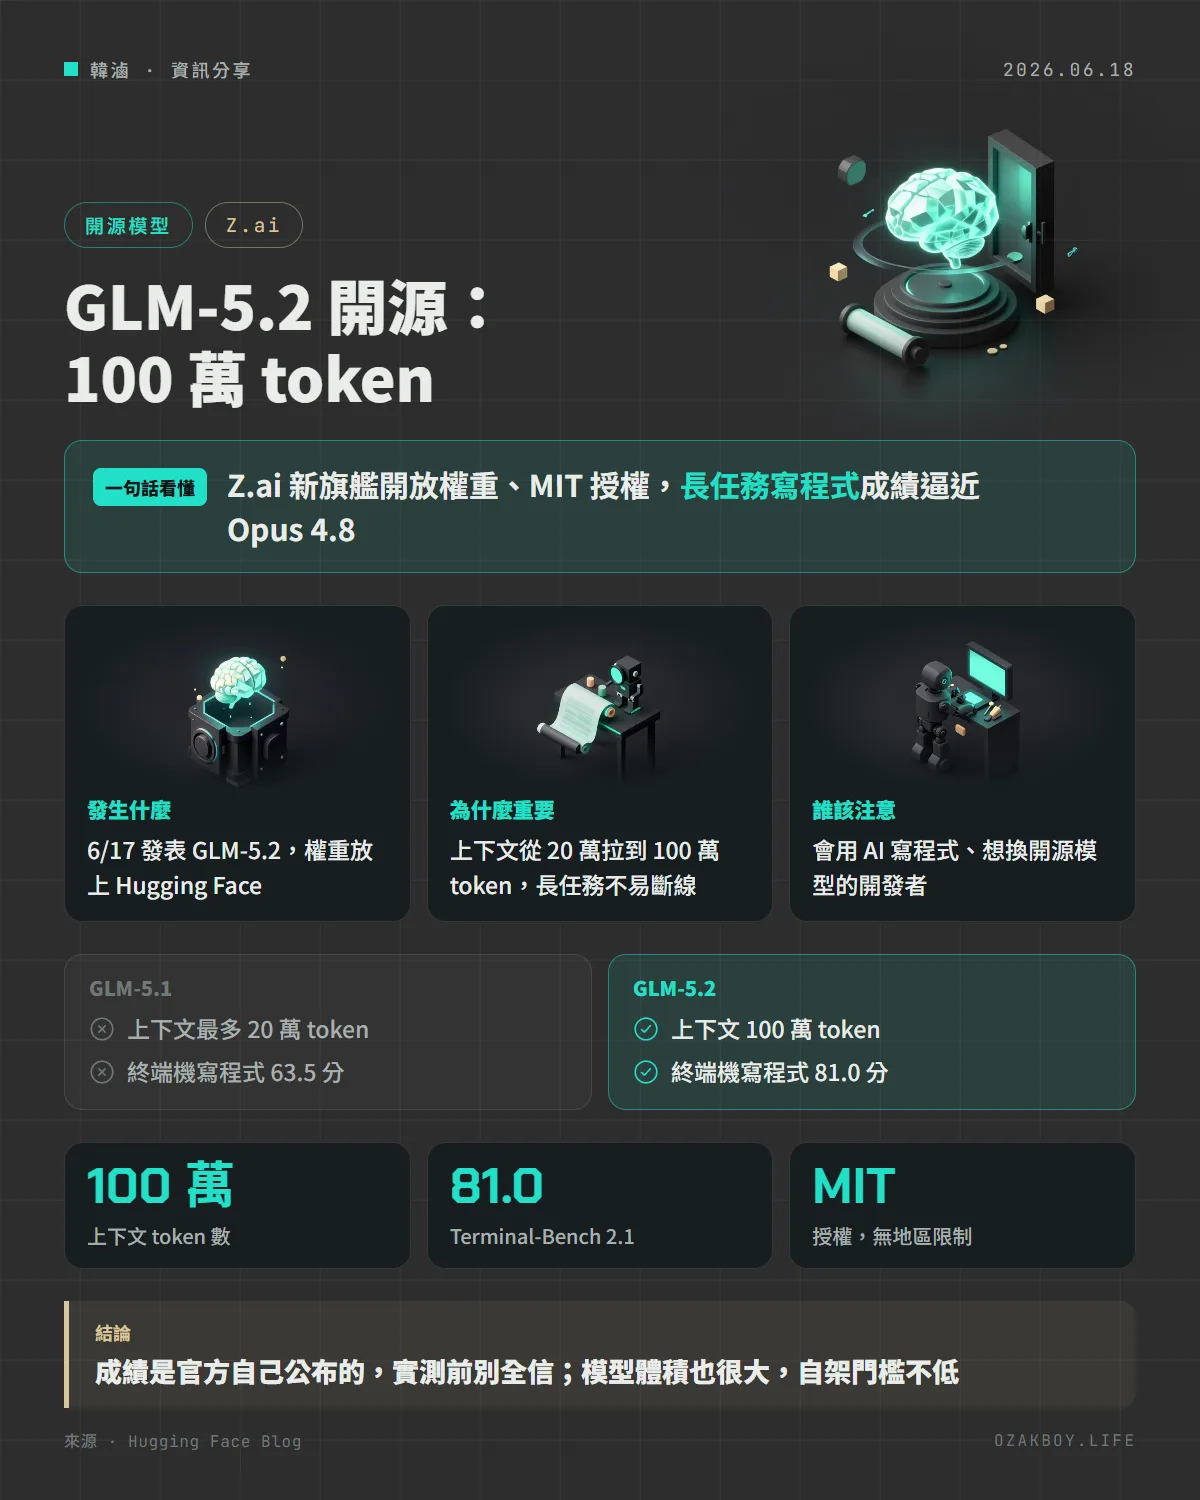
一句話看懂:Z.ai 發表新旗艦模型 GLM-5.2,權重公開、採 MIT 授權,上下文拉到 100 萬 token,官方自己公布的寫程式成績進步很多,逼近 Claude Opus 4.8。
先用白話講:上下文長度是什麼?
想像你在考一場開書考試,桌子只有一張小桌,每次只能攤開幾本參考書。桌子越大,你能同時攤開的資料越多,寫到一半就不用一直翻回去找。
AI 的「上下文長度(context window)」就是這張桌子的大小,單位是 token(AI 計算文字量的單位)。GLM-5.2 的桌子從原本的 20 萬 token,一口氣加大到 100 萬 token。對需要連續做好幾個小時的程式開發任務來說,桌子大,AI 比較不容易做到一半忘了前面改過什麼。
發生什麼事
Z.ai 在 6 月 17 日,於 Hugging Face 部落格發表 GLM-5.2:
- 定位:官方稱它是旗艦模型,主打「長時間任務」,比前代 GLM-5.1 進步很多
- 上下文:最大 100 萬 token,前代是 20 萬
- 授權:MIT 開源授權,官方說明沒有地區限制
- 取得方式:權重放在 Hugging Face 與 ModelScope,也能在 Z.ai 網站上對話,或透過 GLM Coding Plan 使用
- 彈性:新增多段思考強度(High、Max),讓你在「想得多」與「回得快」之間取捨
跟前代、跟 Claude 比
以下是 Z.ai 公布的部分成績(全部是官方自報):
| 測試項目 | GLM-5.1 | GLM-5.2 | Claude Opus 4.8 |
|---|---|---|---|
| Terminal-Bench 2.1(Terminus-2) | 63.5 | 81.0 | 85.0 |
| SWE-bench Pro | 58.4 | 62.1 | 69.2 |
官方的說法是:GLM-5.2 是目前開源模型裡寫程式最強的,在 Terminal-Bench 2.1 離 Opus 4.8 只差幾分,但在 SWE-bench Pro 還有明顯差距。三個長任務測試(FrontierSWE、PostTrainBench、SWE-Marathon)也都是開源模型第一,但有的項目還是落後 Opus 4.8,例如 SWE-Marathon 落後 13%。
怎麼讓 100 萬 token 跑得動
光是把數字寫大不難,難的是便宜又穩定地跑。官方提到兩個做法:
- IndexShare:每 4 層共用同一個索引器,官方說在 100 萬 token 的長度下,每個 token 的運算量減少 2.9 倍
- 加強預測解碼:讓小模型先猜下一步、大模型再驗證的流程,平均一次猜中的長度提升最多 20%(4.56 到 5.47)
給開發者的技術細節
- 下載:Hugging Face 與 ModelScope,可用 transformers、vLLM、SGLang、xLLM、ktransformers 部署
- GLM Coding Plan:訂閱者已可使用,把模型名稱改成
GLM-5.2;在 Claude Code 要開 100 萬上下文,用GLM-5.2[1m] - 額度消耗:官方說這是最強的模型,尖峰時段(北京時間 14:00 到 18:00)消耗 3 倍額度,離峰 2 倍;限時優惠到 9 月底,離峰只算 1 倍
- 評測註記:Terminal-Bench 2.1 是用 Terminus-2 框架、256K 上下文跑出來的;FrontierSWE 由 Proximal 執行、SWE-Marathon 由 Abundant AI 執行、PostTrainBench 由該基準自己的團隊執行,而且都用最高強度設定,與日常使用不一定相同
- 模型大小:Hugging Face 模型頁標示約 7530 億參數(我整理時的頁面資訊),自架前先估算硬體
我的看法
我自己會用本地的 Ollama 跑小模型,也會在 Claude Code 之類的工具裡換模型試試。這次最讓我在意的不是分數,而是「MIT 授權加上 100 萬上下文」的組合:做接案專案時,客戶常常擔心程式碼送到國外,開源權重至少讓「在自己控制的機器上跑」變成可談的選項。
但我也不會直接相信這張成績表。分數都是官方整理,長任務測試用的是最高強度設定,日常寫網站、改系統的狀況不一定一樣。如果打算導入,我會挑一個真實專案的小功能,拿它跟現在用的模型各跑一次,比較改對的比例與花費,再決定。另外,模型太大也是現實問題,多數小團隊比較可能是透過 API 或訂閱方案使用,而不是自己養一台。
名詞小辭典
- 上下文長度(Context Window):AI 一次能同時參考的內容量上限,數字越大,能處理的資料越多。
- 開放權重(Open Weights):把訓練好的模型檔公開,讓大家下載後自己部署、微調。
- MIT 授權:很寬鬆的開源授權,商用、修改、再散布都可以,主要條件是保留原本的授權聲明。
- Terminal-Bench:測試 AI 能不能在命令列環境裡完成實際工作的基準測試,分數越高代表完成率越高。