觀點 · 資訊分享
PaddleOCR 推出 PP-OCRv6:最小 150 萬參數,中型與小型版支援 50 種語言含繁體中文
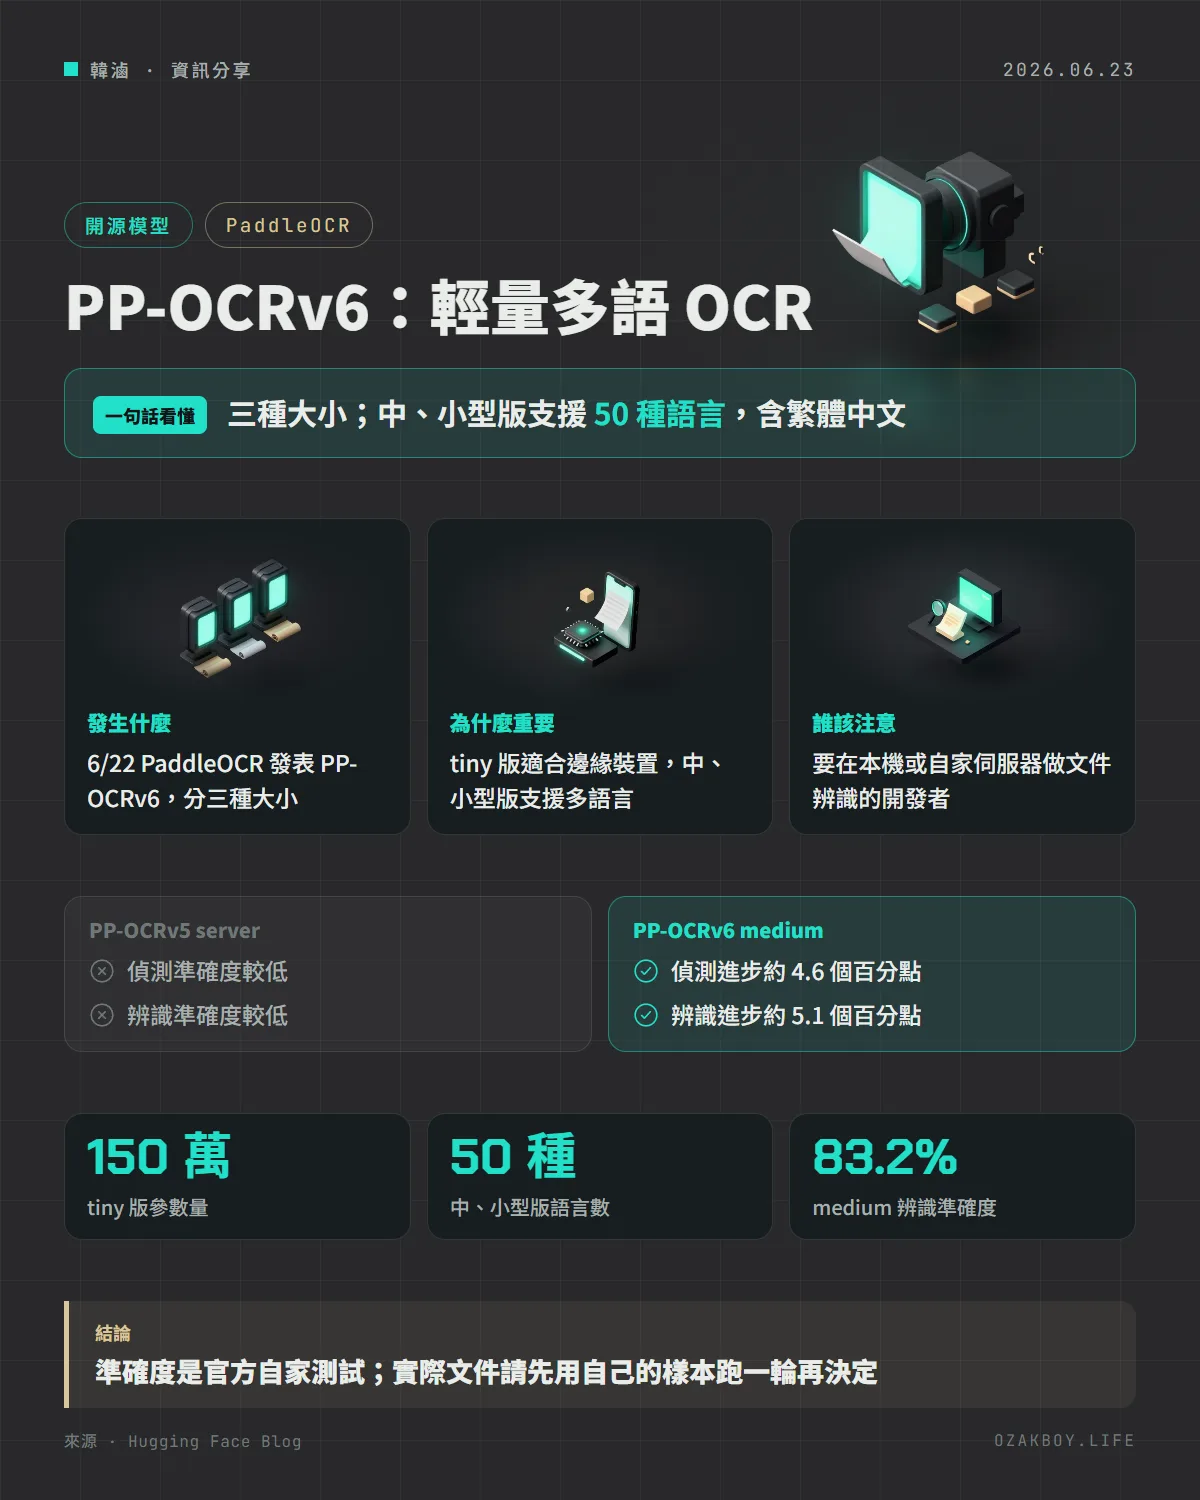
PaddleOCR 推出 PP-OCRv6,分成 tiny、small、medium 三種大小,參數量從 150 萬到 3,450 萬。官方自家測試顯示,medium 比上一代 v5 server 的偵測與辨識準確度各進步約 5 個百分點。
- 發布
- 2026-06-23
- 篇幅
- 約 3 分鐘 · 1,562 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
一句話看懂:PaddleOCR 推出 PP-OCRv6,一套輕量的開源文字辨識模型,分三種大小,最小只有 150 萬參數,最多支援 50 種語言(含繁體中文),官方自家測試顯示準確度比上一代更好。
先用白話講:OCR 是什麼?
想像你要請人把一疊紙本收據,輸入成電腦裡的表格。OCR(光學文字辨識) 就是請 AI 先「看」圖片,找出哪裡有字、再讀出這些字是什麼。
這個過程通常分兩步:第一步偵測,找出圖片裡每一塊文字的位置;第二步辨識,讀出每一塊文字的內容。第一步框歪了,第二步就很難讀對,所以兩步都重要。
發生什麼事
PaddleOCR 團隊在 6 月 22 日於 Hugging Face 部落格發表 PP-OCRv6,這是 PaddleOCR 通用文字辨識模型家族的最新一代:
- 三種大小:tiny(150 萬參數)、small(770 萬)、medium(3,450 萬)
- 多語言:medium 與 small 支援 50 種語言,包含簡體中文、繁體中文、英文、日文,以及 46 種使用拉丁字母的語言
- 適用場景:官方列出文件、截圖、多語言圖片、數位顯示器、工業標籤與自然場景文字
- 多種格式:Hugging Face 上提供 safetensors、Paddle 推論模型與 ONNX 模型
三種大小的成績
以下是官方自家多場景基準的數字:
| 版本 | 參數量 | 偵測 Hmean | 辨識準確度 | 官方建議場景 |
|---|---|---|---|---|
| tiny | 150 萬 | 80.6% | 73.5% | 邊緣裝置、輕量本機辨識 |
| small | 770 萬 | 84.1% | 81.3% | 手機、桌機、兼顧成本的多語言服務 |
| medium | 3,450 萬 | 86.2% | 83.2% | 重視準確度的伺服器端與文件匯入 |
官方說,medium 比上一代 PP-OCRv5_server,偵測進步 4.6 個百分點、辨識進步 5.1 個百分點。這些是官方自家的測試,不是第三方評比。
給開發者的技術細節
- 安裝:
pip install paddleocr - 推論後端:PaddleOCR 3.7 提供統一的
engine選項,可選 Paddle Inference(預設)、Transformers 與 ONNX Runtime - 改用 Transformers 後端:
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
    engine="transformers",
)
result = ocr.predict("圖片網址或本機路徑")
- ONNX:官方說 PP-OCRv6 合集內有 ONNX 版本,用
engine="onnxruntime"執行 - 輸出:結果可存成標註圖與結構化 JSON,方便接到文件解析、搜尋、擷取或 RAG 流程
- 架構:偵測端用 RepLKFPN,辨識端用 EncoderWithLightSVTR,三種大小共用 PPLCNetV4 骨幹
我的看法
我覺得這個方向很實用:小模型、多語言、可以選 ONNX,代表它很適合自架,不用把客戶的文件丟到外部服務。接案時,發票、單據、表單辨識是很常見的需求,這類需求其實不需要超大的視覺語言模型,專門的 OCR 小模型反而更快、更省、更好控制。
不過要提醒:繁體中文的實際表現,官方文章只寫「支援」,沒有分語言給準確度,對手寫、印章、背景複雜的單據,也沒有特別說明。我的做法會是:先拿十幾張客戶的真實樣本跑一輪,比較 tiny、small、medium 的差異,再決定要放在哪台機器上。
名詞小辭典
- OCR:光學文字辨識,把圖片中的文字轉成可編輯、可搜尋的文字。
- 參數量:模型內部可調整數值的總數,一般來說越大越準,但也越耗資源。
- Hmean:偵測任務常用的綜合指標,同時考慮找得準與找得全。
- ONNX Runtime:跨平台的模型執行引擎,讓同一個模型能在不同環境與硬體上跑。