觀點 · 資訊分享
Grok 4.7 發表:價格維持每百萬 token 2/6 美元,寫程式分數進步但仍落後 Fable 5.1
Grok 開發商發表 Grok 4.7,換上更大的基礎模型、主打長時間寫程式與知識工作,價格和速度跟 4.6 一樣。官方自家評測多項進步,但在終端機任務等評測仍明顯落後 Claude Fable 5.1。
- 發布
- 2026-09-21
- 篇幅
- 約 4 分鐘 · 1,720 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
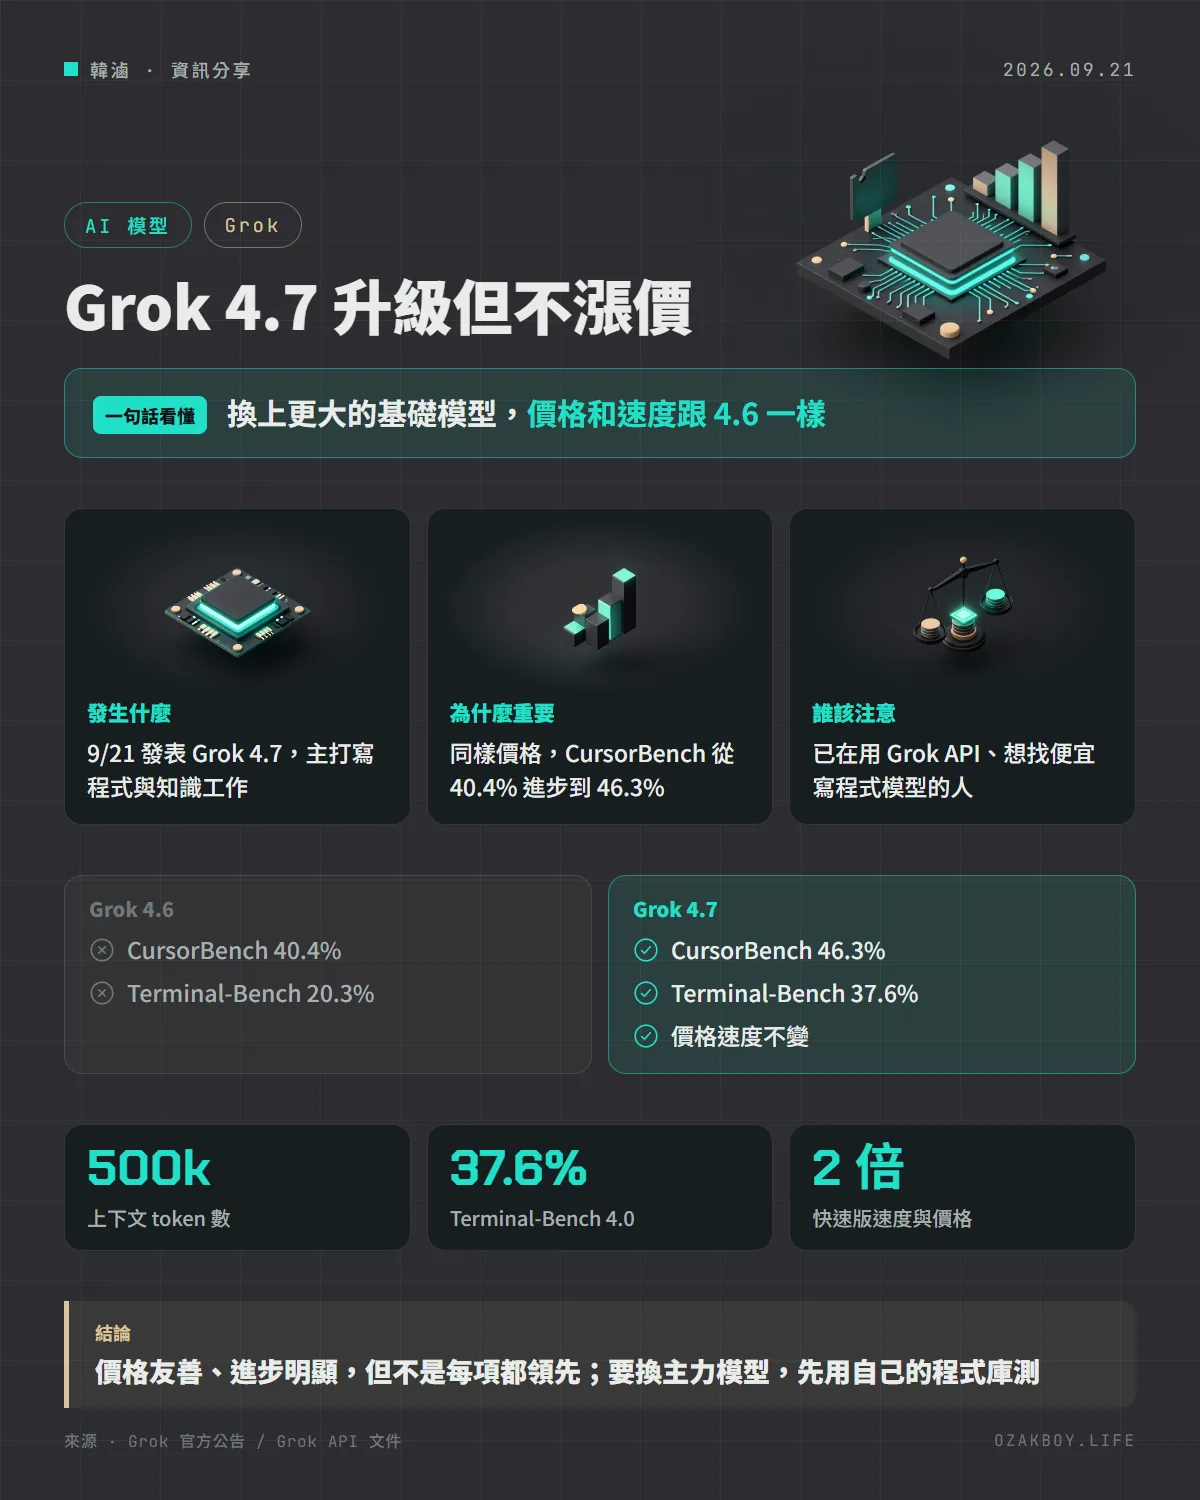
一句話看懂:Grok 4.7 換上更大的基礎模型、寫程式能力明顯進步,價格卻跟 4.6 一樣;但官方自家評測也顯示,它在幾項關鍵任務仍落後 Claude Fable 5.1。
先用白話講:「換基礎模型、價格不變」代表什麼?
想像你常去的便當店把廚師換成更厲害的師傅,菜色變好吃,價格卻一塊錢都沒漲。對常客來說,這就是白賺。
AI 模型的「基礎模型」就像廚師本人的功力,「強化學習」則像師傅上崗前的特訓。Grok 4.7 兩件事都升級了,但 API 價格維持原樣。
發生什麼事
Grok 的開發商(官網 x.ai)在 9 月 21 日發表 Grok 4.7:
- 官方定位:旗下寫程式與知識工作能力最強的模型
- 使用比 Grok 4.6 更大的基礎模型,並用更長時間、偏重「需要好幾小時才能完成」的任務做強化學習
- 更會檢查自己的工作、處理更長的上下文
- 價格與速度跟 Grok 4.6 相同:每百萬 token 輸入 2 美元、輸出 6 美元
- 另有快速版:輸出速度 2 倍,價格也 2 倍
- 已上架 Cursor、Grok Build,也可透過 Grok API、第三方寫程式工具與雲端平台使用
官方評測怎麼看?
官方公布的比較表(Grok 4.7 使用 xHigh 推理強度,其他模型用的強度不同):
| 評測 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 輸入/輸出價格(美元/百萬 token) | 2/6 | 2/6 | 4/20 | 10/50 |
| CursorBench 4.0(寫程式) | 46.3% | 40.4% | 41.7% | 51.8% |
| Terminal-Bench 4.0(終端機長任務) | 37.6% | 20.3% | 37.3% | 57.9% |
| EEBench(電機工程) | 64.0% | 53.0% | 39.4% | 56.4% |
| HealthBench Professional(臨床推理) | 56.7% | 48.5% | 60.5% | 62.1% |
可以看到,Grok 4.7 比 4.6 每一項都進步,在 EEBench 也拿到最高分;但寫程式與終端機任務仍落後 Fable 5.1。要注意,這些都是官方自己的評測,而且各模型使用的推理強度不一樣。
給開發者的技術細節
依 Grok API 文件:
- 模型名稱:
grok-4.7 - 上下文長度:500k token,推理強度可調整
- 知識截止:2026 年 5 月
- 在 Responses API 上,
grok-4.7一律回傳reasoning.encrypted_content(加密的推理內容) grok-4.20之後的模型不支援logprobs,設定了也會被忽略- 模型名稱有別名機制:
<模型名>指向最新穩定版,<模型名>-latest指向最新版,加日期的版本則固定不變
安全方面,官方說 Grok 4.7 採用全新的防護機制,在 LatchBio 的生物安全評測拿到 62.4%,在自家 HackerBench v0.3 只讓 3.3% 的高風險雙重用途提示通過。
我的看法
對接案者來說,這次最有感的是「不漲價」。每百萬 token 輸出 6 美元,跟官方表上 Fable 5.1 的 50 美元比,差了 8 倍以上(自行換算:50 ÷ 6,只比輸出單價、不含用量差異),大量、重複性高的程式工作很適合拿來試。
但我不會因為一張官方表格就換主力模型。表裡的推理強度各不相同,加上 Terminal-Bench 這種長任務落差很大。比較實際的做法是:挑幾個自己專案裡的真實任務,同時丟給兩三個模型跑,看品質、花費和需要修幾次,再決定哪些工作交給便宜的模型。
名詞小辭典
- 基礎模型(Base Model):模型最底層的大型神經網路,決定它的基本能力上限。
- 強化學習(Reinforcement Learning):讓模型反覆嘗試、依結果好壞給回饋來改進的訓練方式。
- 上下文(Context):模型一次能讀進的內容長度,越長越能處理大型專案。
- 推理強度(Reasoning Effort):模型回答前「想多久」的設定,越高通常越準,但越慢、越貴。